决策树
决策树简介
学习目标
1.理解决策树算法的基本思想
2.知道构建决策树的步骤
【理解】决策树例子
决策树算法是一种监督学习算法,英文是Decision tree。
决策树思想的来源非常朴素,试想每个人的大脑都有类似于if-else这样的逻辑判断,这其中的if表示的是条件,if之后的else就是一种选择或决策。程序设计中的条件分支结构就是if-else结构,最早的决策树就是利用这类结构分割数据的一种分类学习方法。
比如:你母亲要给你介绍男朋友,是这么来对话的:
女儿:多大年纪了?
母亲:26。
女儿:长的帅不帅?
母亲:挺帅的。
女儿:收入高不?
母亲:不算很高,中等情况。
女儿:是公务员不?
母亲:是,在税务局上班呢。
女儿:那好,我去见见。
于是你在脑袋里面就有了下面这张图:
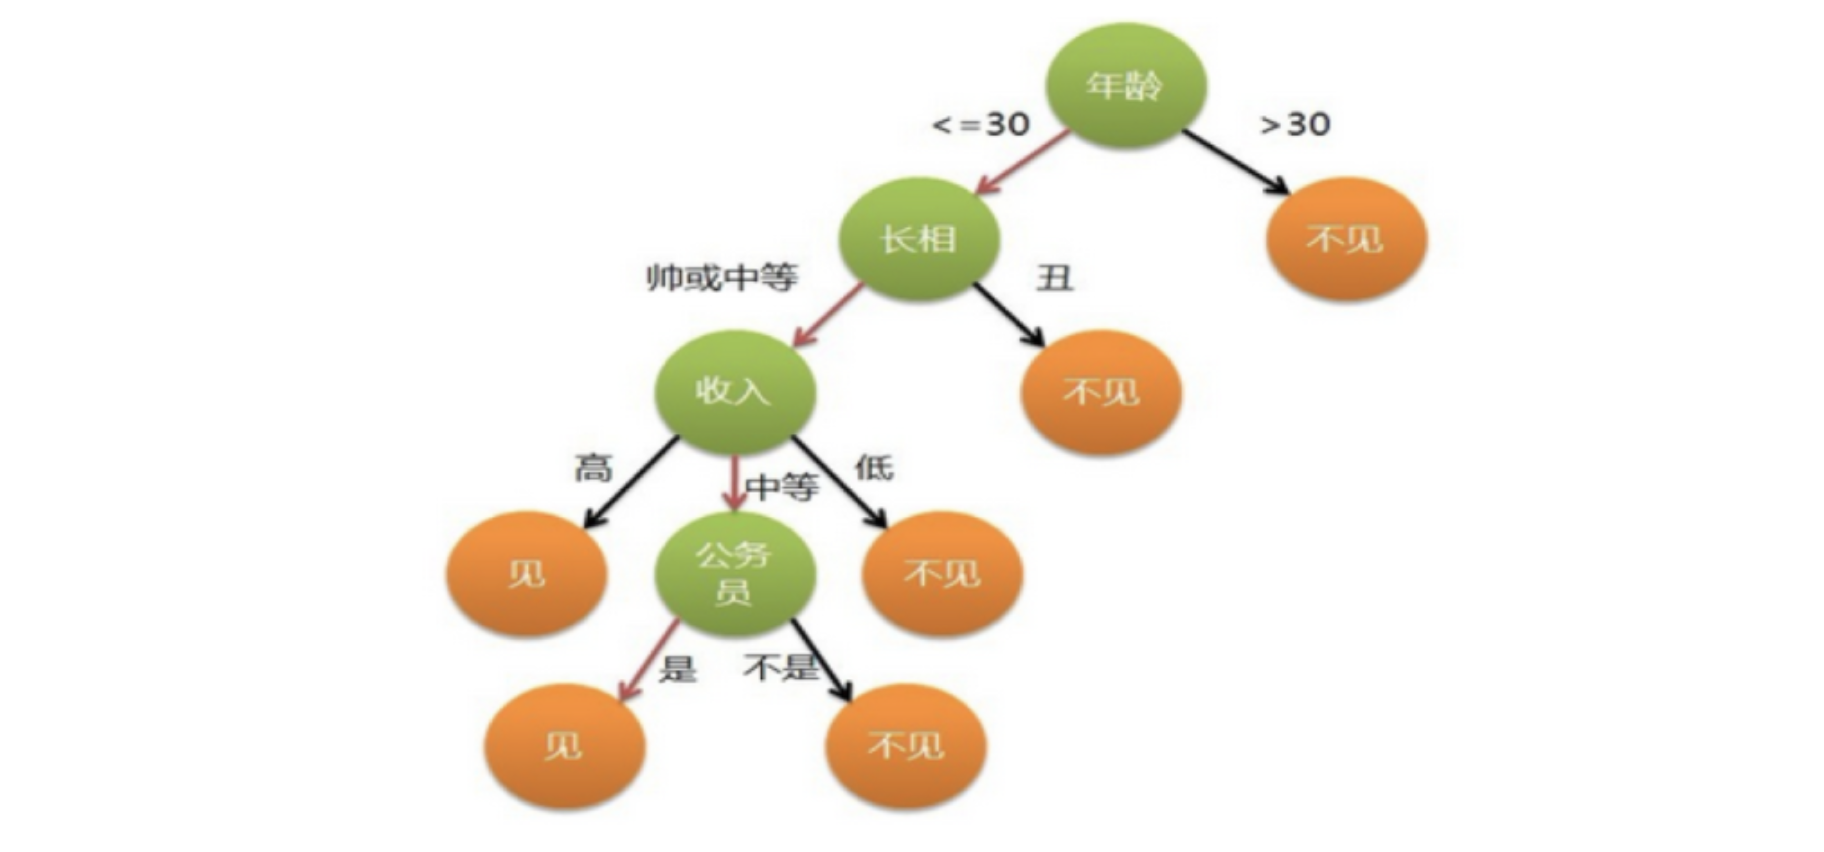
作为女孩的你在决策过程就是典型的分类树决策。相当于通过年龄、长相、收入和是否公务员对将男人分为两个类别:见和不见。
【知道】决策树简介
决策树是什么?
决策树是一种树形结构,树中每个内部节点表示一个特征上的判断,每个分支代表一个判断结果的输出,每个叶子节点代表一种分类结果
决策树的建立过程:
1.特征选择:选取有较强分类能力的特征。
2.决策树生成:根据选择的特征生成决策树。
3.决策树也易过拟合,采用剪枝的方法缓解过拟合。
CART决策树
学习目标:
1.理解基尼指数的作用
2.知道cart构建的特征选择方法
【知道】Cart树简介
Cart模型是一种决策树模型,它即可以用于分类,也可以用于回归。
分类和回归树模型采用不同的最优化策略。Cart回归树使用平方误差最小化策略,Cart分类生成树采用的基尼指数最小化策略。
【理解】基尼指数计算方法
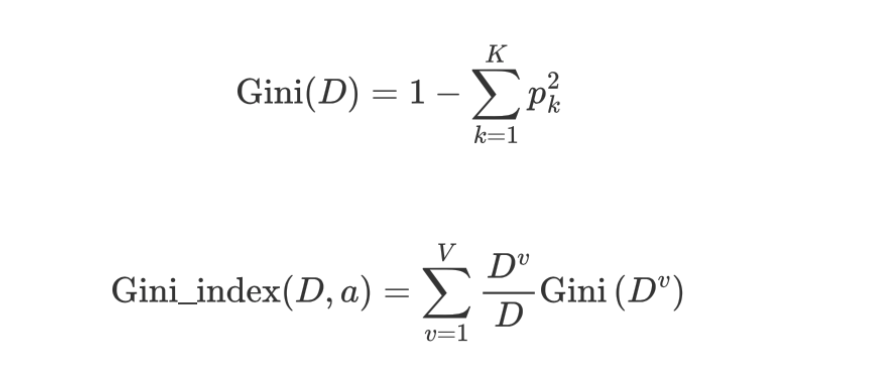
-
信息增益(ID3)、信息增益率值越大(C4.5),则说明优先选择该特征。
-
基尼指数值越小(cart),则说明优先选择该特征。
【知道】比较
| 名称 | 提出时间 | 分支方式 | 特点 |
|---|---|---|---|
| ID3 | 1975 | 信息增益 | 1.ID3只能对离散属性的数据集构成决策树 2.倾向于选择取值较多的属性 |
| C4.5 | 1993 | 信息增益率 | 1.缓解了ID3分支过程中总喜欢偏向选择值较多的属性 2.可处理连续数值型属性,也增加了对缺失值的处理方法 3.只适合于能够驻留于内存的数据集,大数据集无能为力 |
| CART | 1984 | 基尼指数 | 1.可以进行分类和回归,可处理离散属性,也可以处理连续属性 2.采用基尼指数,计算量减小 3.一定是二叉树 |
【实践】泰坦尼克号生存案例
案例背景
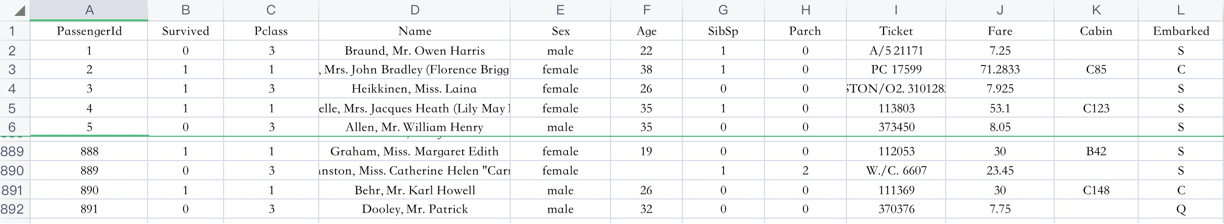
泰坦尼克号沉没是历史上最著名的沉船事件。1912年4月15日,在她的处女航中,泰坦尼克号在与冰山相撞后沉没,在2224名乘客和船员中造成1502人死亡。这场耸人听闻的悲剧震惊了国际社会,并为船舶制定了更好的安全规定。 造成海难失事的原因之一是乘客和船员没有足够的救生艇。尽管幸存下来有一些运气因素,但有些人比其他人更容易生存,例如妇女,儿童和社会地位较高的人群。 在这个案例中,我们要求您完成对哪些人可能存活的分析。
数据集中的特征包括票的类别,是否存活,乘坐班次,姓名,年龄,上船港口,房间,性别等。
API介绍
class sklearn.tree.DecisionTreeClassifier(criterion=’gini’, max_depth=None,random_state=None)
- criterion
- 特征选择标准
- “gini”或者”entropy”,前者代表基尼系数,后者代表信息增益。一默认”gini”,即CART算法。
- min_samples_split
- 内部节点再划分所需最小样本数
- 这个值限制了子树继续划分的条件,如果某节点的样本数少于min_samples_split,则不会继续再尝试选择最优特征来进行划分。 默认是2.如果样本量不大,不需要管这个值。如果样本量数量级非常大,则推荐增大这个值。我之前的一个项目例子,有大概10万样本,建立决策树时,我选择了min_samples_split=10。可以作为参考。
- min_samples_leaf
- 叶子节点最少样本数
- 这个值限制了叶子节点最少的样本数,如果某叶子节点数目小于样本数,则会和兄弟节点一起被剪枝。 默认是1,可以输入最少的样本数的整数,或者最少样本数占样本总数的百分比。如果样本量不大,不需要管这个值。如果样本量数量级非常大,则推荐增大这个值。之前的10万样本项目使用min_samples_leaf的值为5,仅供参考。
- max_depth
- 决策树最大深度
- 决策树的最大深度,默认可以不输入,如果不输入的话,决策树在建立子树的时候不会限制子树的深度。一般来说,数据少或者特征少的时候可以不管这个值。如果模型样本量多,特征也多的情况下,推荐限制这个最大深度,具体的取值取决于数据的分布。常用的可以取值10-100之间
- random_state
- 随机数种子
案例实现
相比其他学习模型,决策树在模型描述上有巨大的优势,决策树的逻辑推断非常直观,具有清晰的可解释性,也有很方便的模型的可视化。在决策树的使用中,无需考虑对数据量化和标准化,就能达到比较好的识别率。
回归决策树
学习目标:
1.了解回归决策树的构建原理
2.能利用回归决策树API解决问题
【了解】回归决策树构建原理
CART 回归树和 CART 分类树的不同之处在于:
- CART 分类树预测输出的是一个离散值,CART 回归树预测输出的是一个连续值。
- CART 分类树使用基尼指数作为划分、构建树的依据,CART 回归树使用平方损失。
- 分类树使用叶子节点里出现更多次数的类别作为预测类别,回归树则采用叶子节点里均值作为预测输出
【实践】回归决策树实践
"""
案例:
    演示用 CART回归树 完成 波士顿房价预测案例.
"""

# 导包
import pandas as pd
import numpy as np
from sklearn.preprocessing import StandardScaler        # 特征预处理 -> 标准化
from sklearn.model_selection import train_test_split    # 训练集和测试集的切分.
from sklearn.metrics import mean_squared_error, root_mean_squared_error, mean_absolute_error  # 评估指标: MSE,RMSE,MAE
from sklearn.tree import DecisionTreeRegressor   # 回归决策树对象

# 1.加载数据 -> 波士顿房价预测.
data_url = "http://lib.stat.cmu.edu/datasets/boston"
raw_df = pd.read_csv(data_url, sep="\/s+", skiprows=22, header=None)
data = np.hstack([raw_df.values[::2, :], raw_df.values[1::2, :2]])  # hstack()函数: 水平拼接数组.
target = raw_df.values[1::2, 2]

# 2. 数据预处理.
x_train, x_test, y_train, y_test = train_test_split(data, target, test_size=0.2, random_state=30)

# 3. 特征工程.
transfer = StandardScaler()     # 标准化对象.
x_train = transfer.fit_transform(x_train)   # 训练集进行标准化处理.
x_test = transfer.transform(x_test)

# 4. 模型训练.
estimator = DecisionTreeRegressor()
estimator.fit(x_train, y_train)

# 5. 模型预测.
y_predict = estimator.predict(x_test)
print("预测值: /n", y_predict)

# 6. 模型评估.
print(f'MSE: {mean_squared_error(y_test, y_predict)}')          # MSE: 12.144803921568627
print(f'RMSE: {root_mean_squared_error(y_test, y_predict)}')    # RMSE: 3.484939586501985
print(f'MAE: {mean_absolute_error(y_test, y_predict)}')         # MAE: 2.7205882352941173
决策树剪枝
学习目标:
- 知道什么是剪枝
- 理解剪枝的作用
- 知道常用剪枝方法
- 了解不同剪枝方法的优缺点
【知道】什么是剪枝?
剪枝 (pruning)是决策树学习算法对付 过拟合 的主要手段。
在决策树学习中,为了尽可能正确分类训练样本,结点划分过程将不断重复,有时会造成决策树分支过多,这时就可能因训练样本学得”太好”了,以致于把训练集自身的一些特点当作所有数据都具有的一般性质而导致过拟合。因此,可通过主动去掉一些分支来降低过拟合的风险。
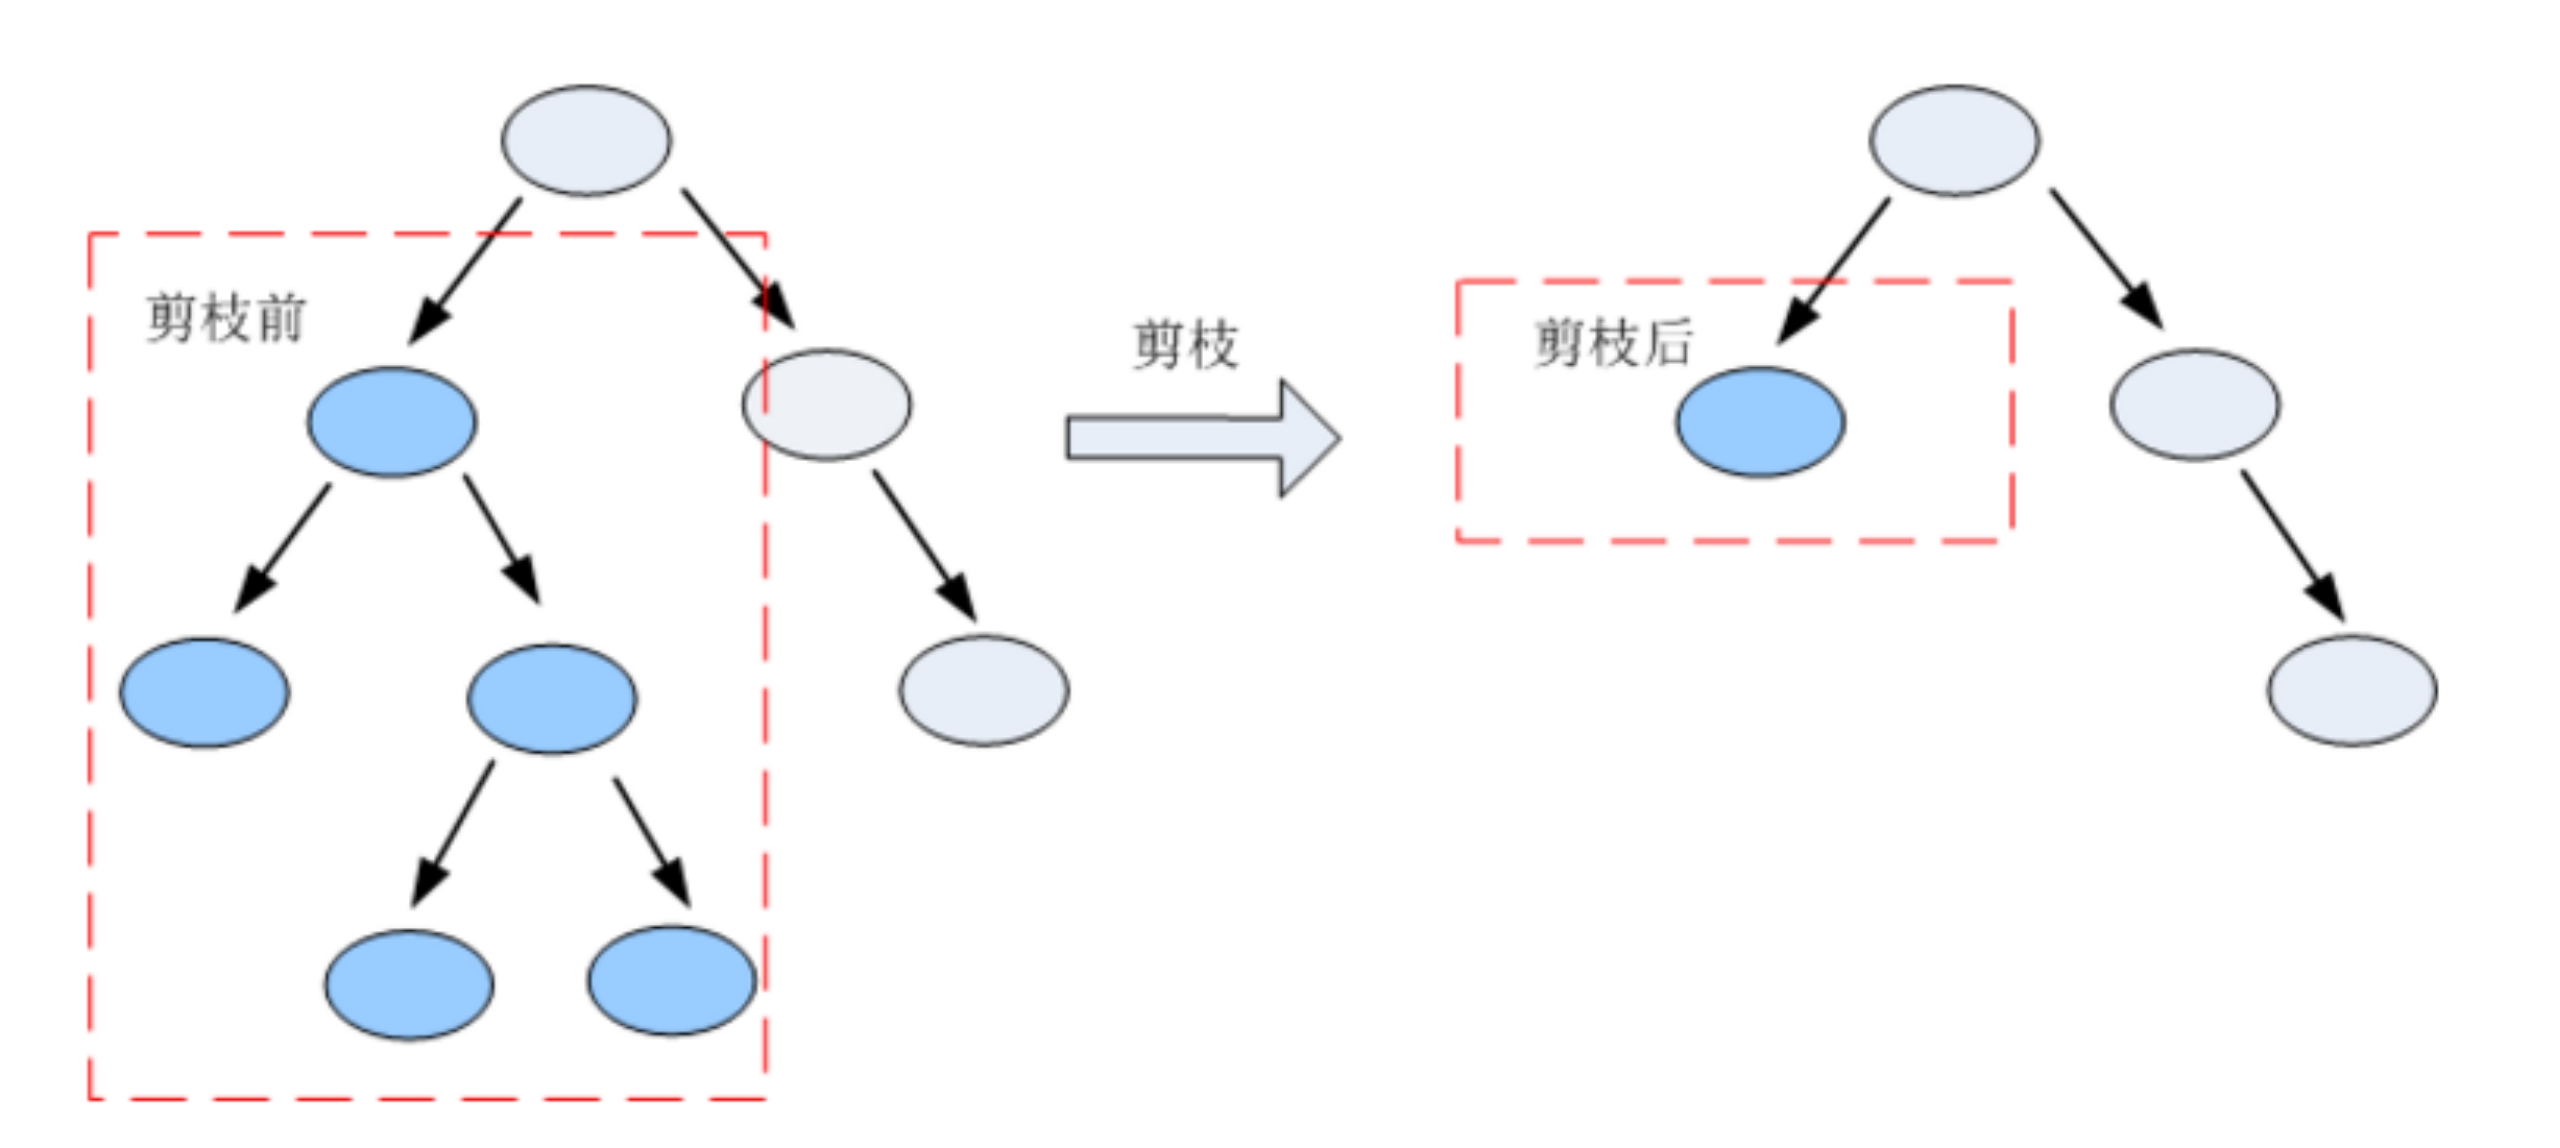
剪枝是指将一颗子树的子节点全部删掉,利用叶子节点替换子树(实质上是后剪枝技术),也可以(假定当前对以root为根的子树进行剪枝)只保留根节点本身而删除所有的叶子,以下图为例:
【知道】常见减枝方法汇总
决策树剪枝的基本策略有”预剪枝” (pre-pruning)和”后剪枝”(post- pruning) 。
- 预剪枝是指在决策树生成过程中,对每个结点在划分前先进行估计,若当前结点的划分不能带来决策树泛化性能提升,则停止划分并将当前结点标记为叶结点;
- 后剪枝则是先从训练集生成一棵完整的决策树,然后自底向上地对非叶结点进行考察,若将该结点对应的子树替换为叶结点能带来决策树泛化性能提升,则将该子树替换为叶结点。
【理解】例子
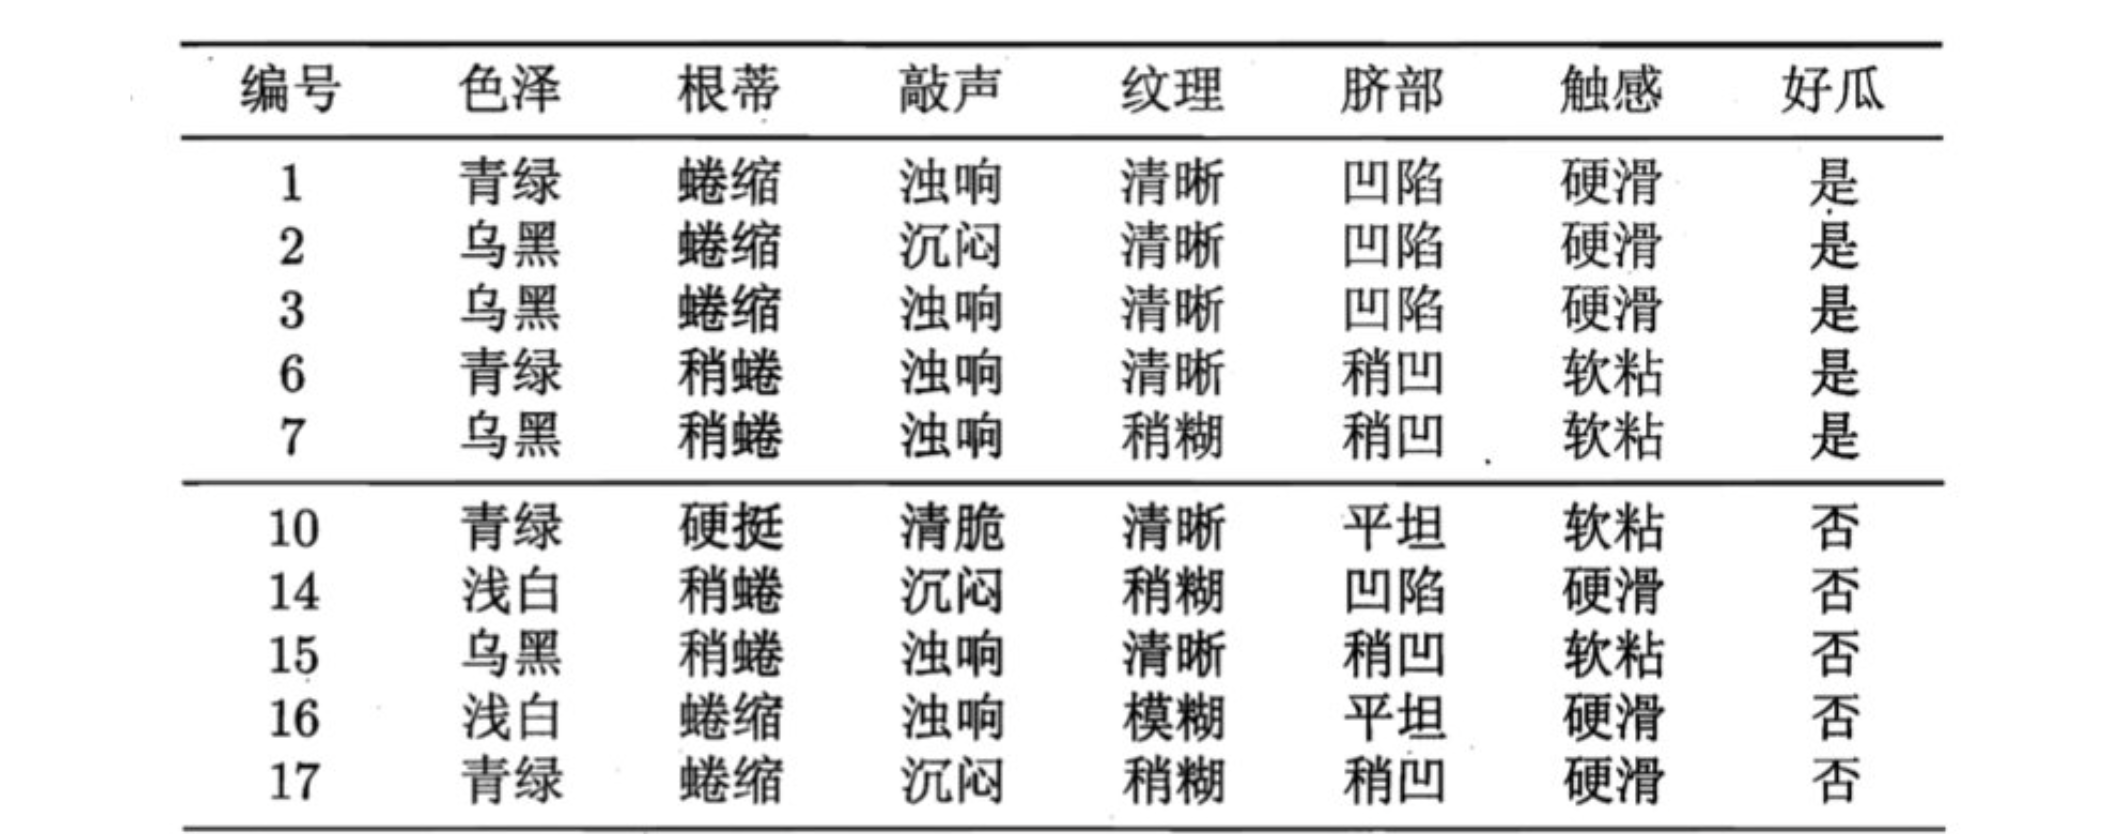
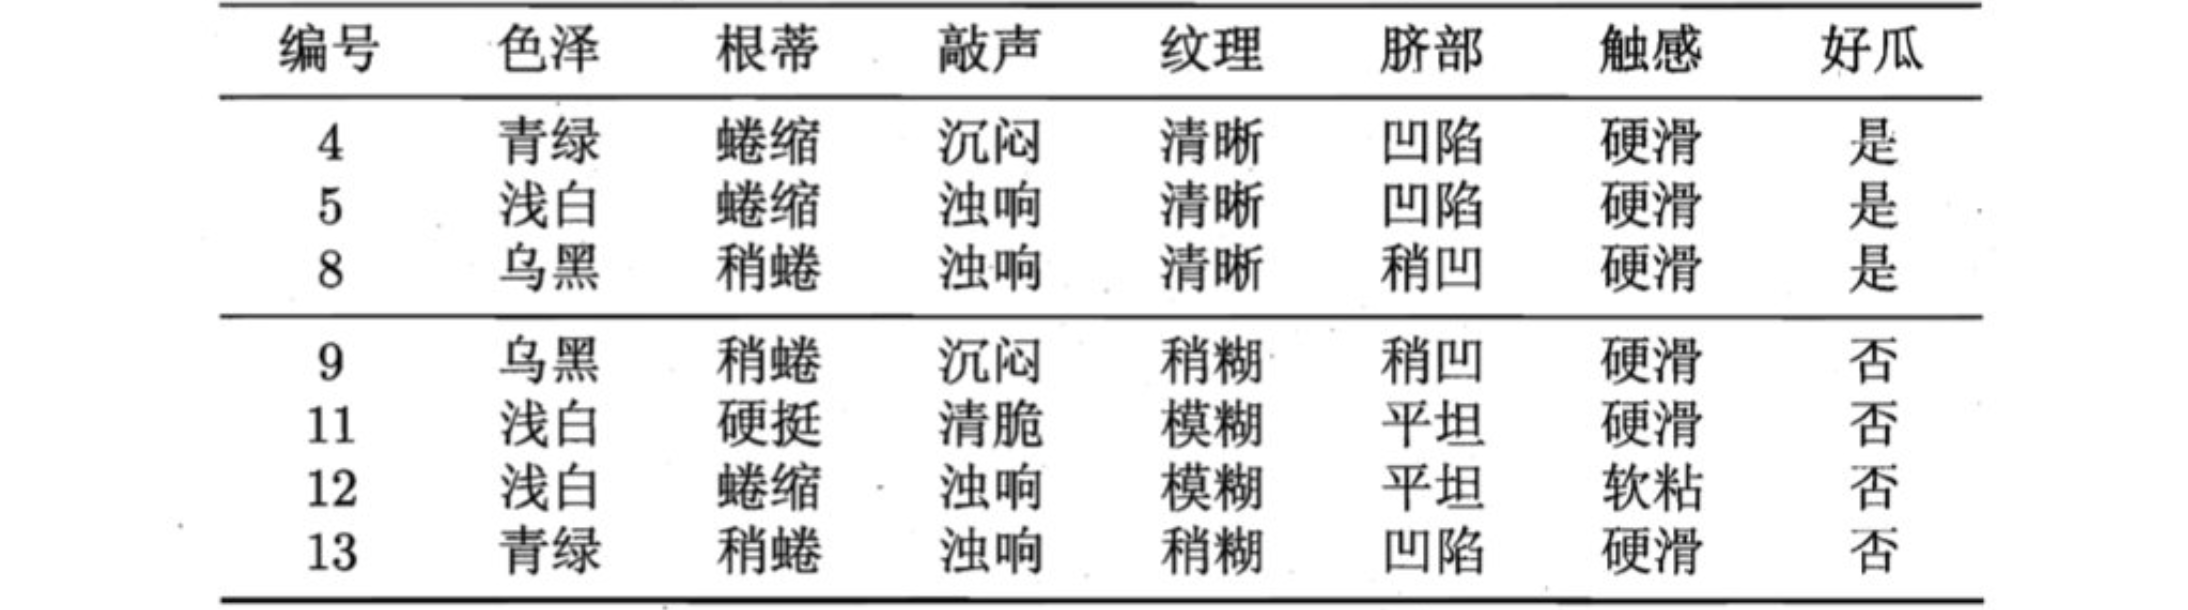
在构建树时, 为了能够实现剪枝, 可预留一部分数据用作 “验证集” 以进行性能评估。我们的训练集如下:
验证集如下:
预剪枝
-
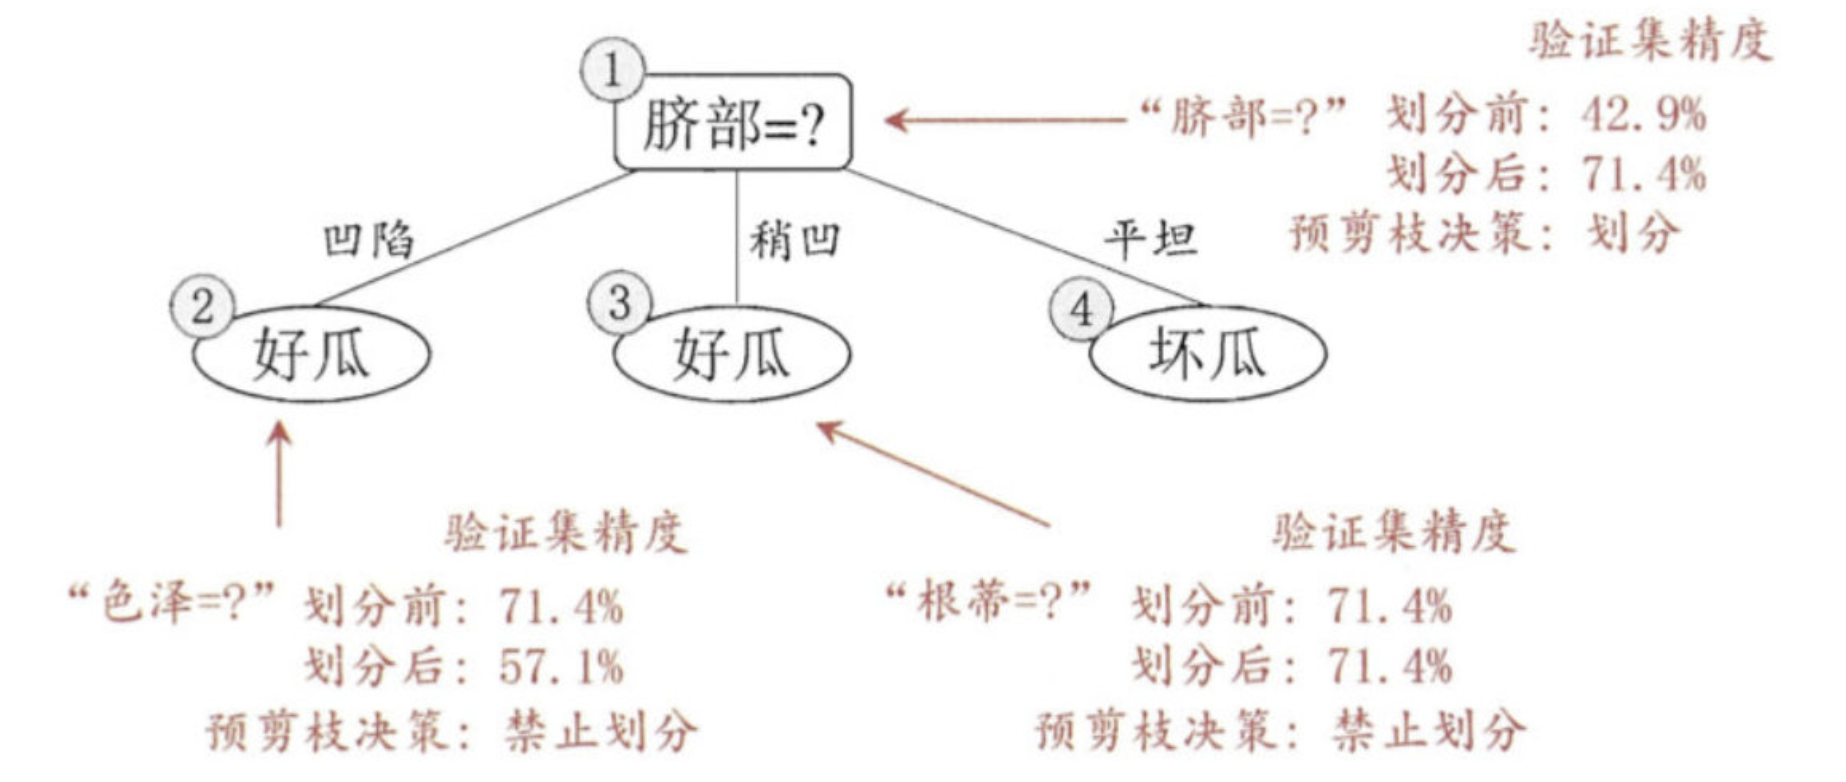
假设: 当前树只有一个结点, 即编号为1的结点. 此时, 所有的样本预测类别为: 其类别标记为训练样例数最多的类别,假设我们将这个叶结点标记为 “好瓜”。此时, 在验证集上所有的样本都会被预测为 “好瓜”, 此时的准确率为: 3/7
-
如果进行此次分裂, 则树的深度为 2, 有三个分支. 在用属性”脐部”划分之后,上图中的结点2、3、4分别包含编号为 {1,2,3, 14}、 {6,7, 15, 17}、 {10, 16} 的训练样例,因此这 3 个结点分别被标记为叶结点”好瓜”、 “好瓜”、 “坏瓜”。此时, 在验证集上 4、5、8、11、12 样本预测正确,准确率为: 5/7。很显然, 通过此次分裂准确率有所提升, 值得分裂.
-
接下来,对结点2进行划分,基于信息增益准则将挑选出划分属性”色泽”。然而,在使用”色泽”划分后,编号为 {5} 的验证集样本分类结果会由正确转为错误,使得验证集精度下降为 57.1%。于是,预剪枝策略将禁止结点2被划分。
-
对结点3,最优划分属性为”根蒂”,划分后验证集精度仍为 5/7. 这个 划分不能提升验证集精度,于是,预剪枝策略禁止结点3被划分。
-
对结点4,其所含训练样例己属于同一类,不再进行划分.
于是,基于预剪枝策略从上表数据所生成的决策树如上图所示,其验证集精度为 71.4%. 这是一棵仅有一层划分的决策树。
后剪枝
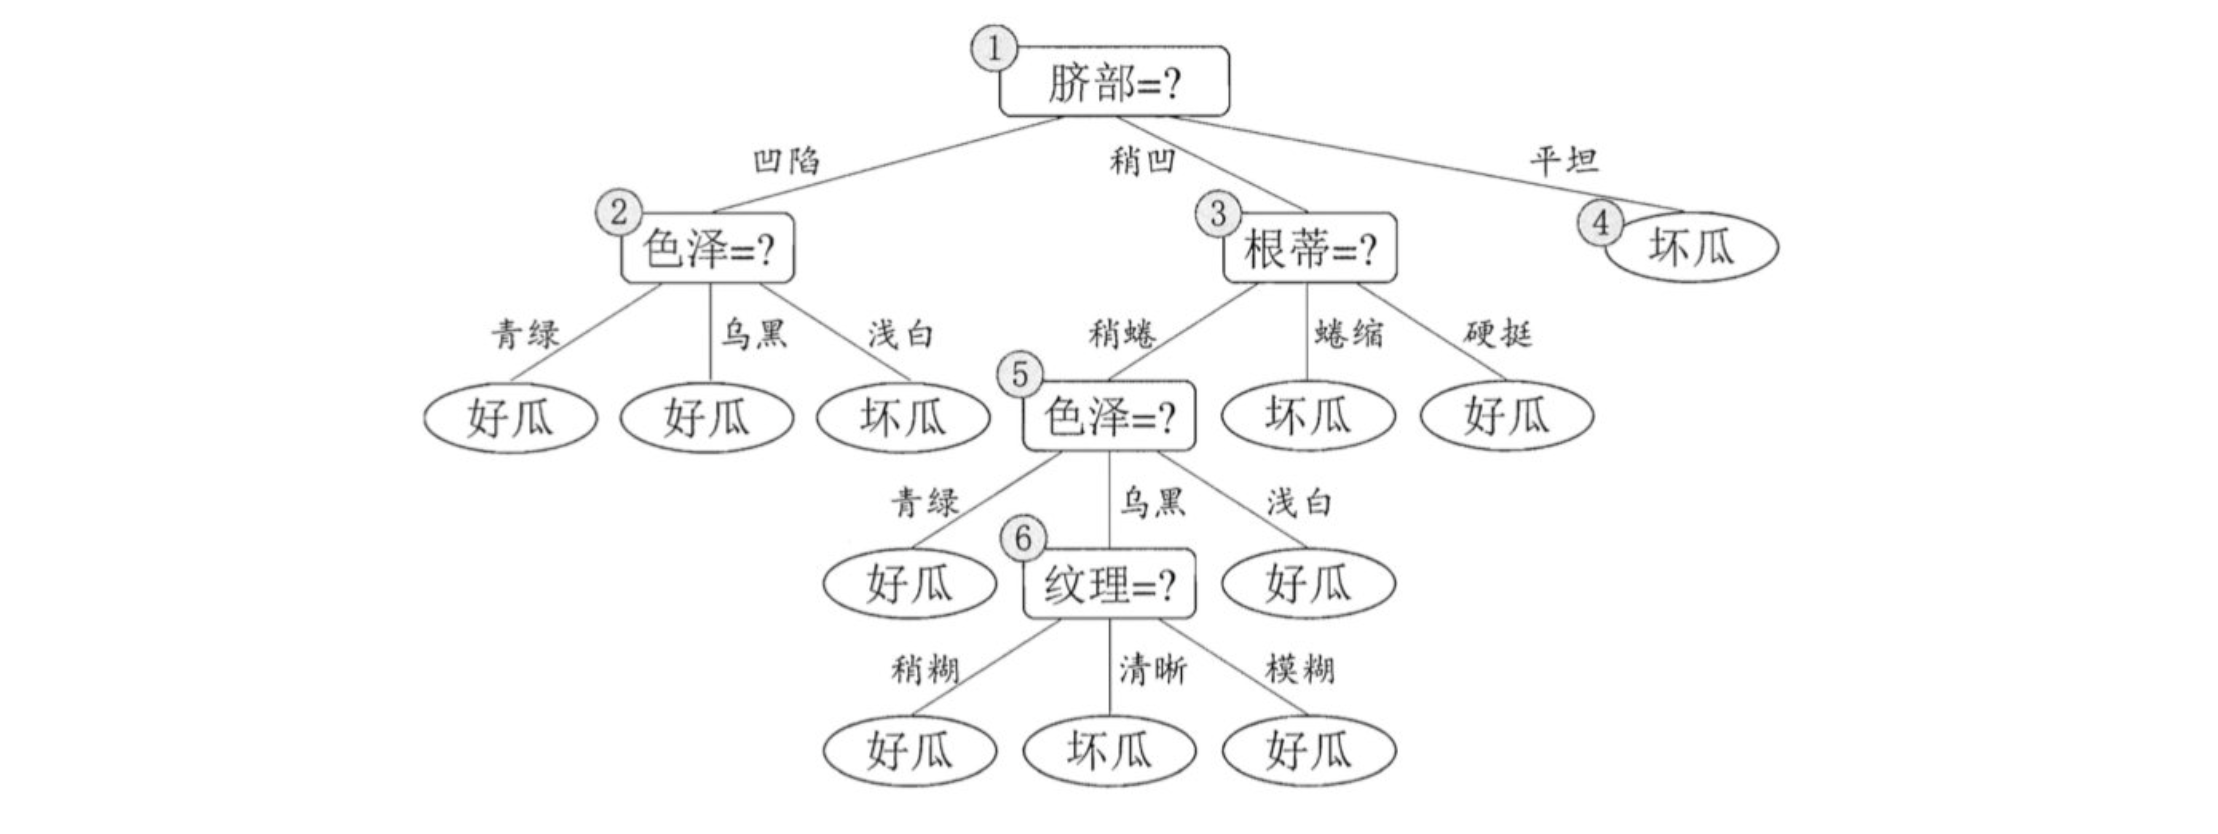
后剪枝先从训练集生成一棵完整决策树,继续使用上面的案例,从前面计算,我们知前面构造的决策树的验证集精度为42.9%。
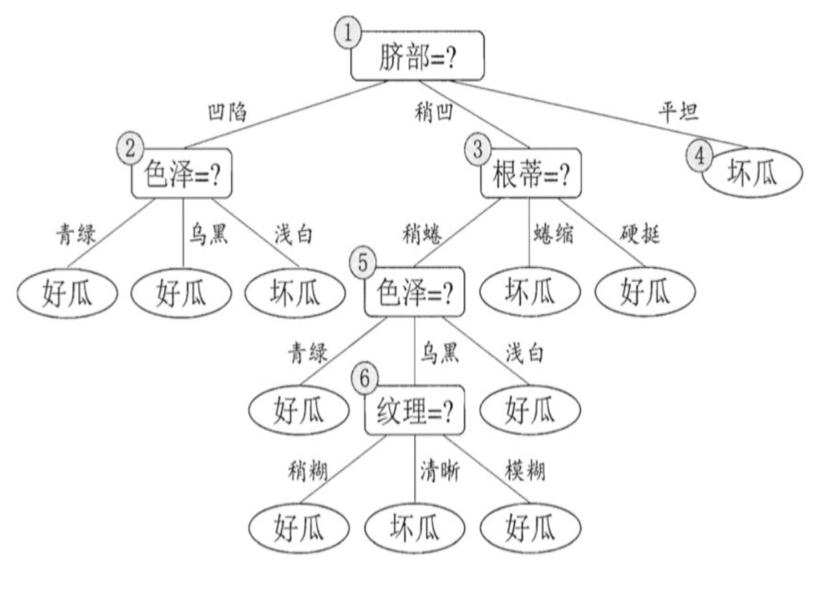
- 首先考察结点6,若将其领衔的分支剪除则相当于把6替换为叶结点。替换后的叶结点包含编号为 {7, 15} 的训练样本,于是该叶结点的类别标记为”好瓜”, 此时决策树的验证集精度提高至 57.1%。
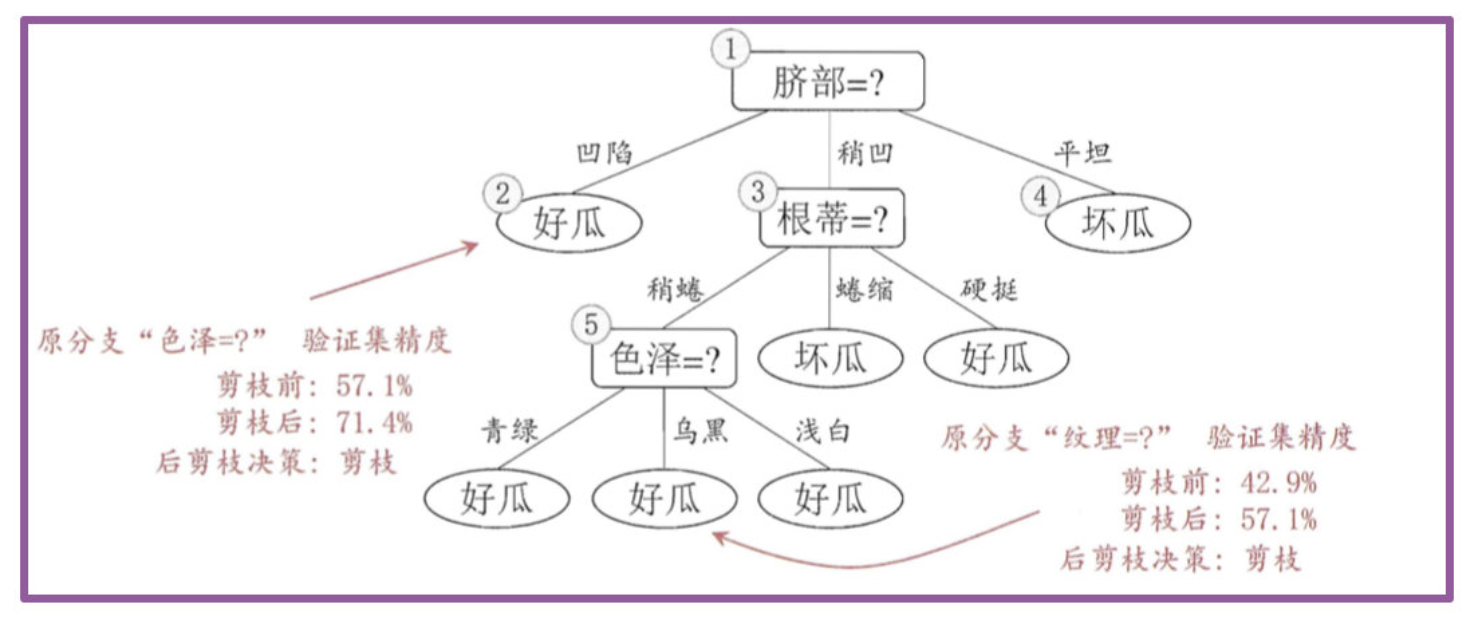
- 然后考察结点5,若将其领衔的子树替换为叶结点,则替换后的叶结点包含编号为 {6,7,15}的训练样例,叶结点类别标记为”好瓜’;此时决策树验证集精度仍为 57.1%. 于是,可以不进行剪枝.
- 对结点2,若将其领衔的子树替换为叶结点,则替换后的叶结点包含编号 为 {1, 2, 3, 14} 的训练样例,叶结点标记为”好瓜”此时决策树的验证集精度提高至 71.4%. 于是,后剪枝策略决定剪枝.
- 对结点3和1,若将其领衔的子树替换为叶结点,则所得决策树的验证集 精度分别为 71.4% 与 42.9%,均未得到提高,于是它们被保留。
- 最终, 基于后剪枝策略生成的决策树如上图所示, 其验证集精度为 71.4%。
【了解】剪枝方法对比
预剪枝优点:
- 预剪枝使决策树的很多分支没有展开,不单降低了过拟合风险,还显著减少了决策树的训练、测试时间开销
预剪枝缺点:
- 有些分支的当前划分虽不能提升泛化性能,甚至会导致泛化性能降低,但在其基础上进行的后续划分却有可能导致性能的显著提高
- 预剪枝决策树也带来了欠拟合的风险
后剪枝优点:
- 比预剪枝保留了更多的分支。一般情况下,后剪枝决策树的欠拟合风险很小,泛化性能往往优于预剪枝
后剪枝缺点:
- 但后剪枝过程是在生成完全决策树之后进行的,并且要自底向上地对树中所有非叶子节点进行逐一考察,因此在训练时间开销比未剪枝的决策树和预剪枝的决策树都要大得多。
作业
1.完成决策树部分的思维导图
2.课上所有的案例都要自己手动完成
3.说明CART分类树和回归树的特点,并说明构建过程
4.说明决策树剪枝的方法有哪些?及各自的特点是什么?