聚类
聚类算法简介
学习目标:
1.知道什么是聚类
2.了解聚类算法的应用场景
3.知道聚类算法的分类
【知道】聚类算法介绍
一种典型的无监督学习算法,主要用于将相似的样本自动归到一个类别中。
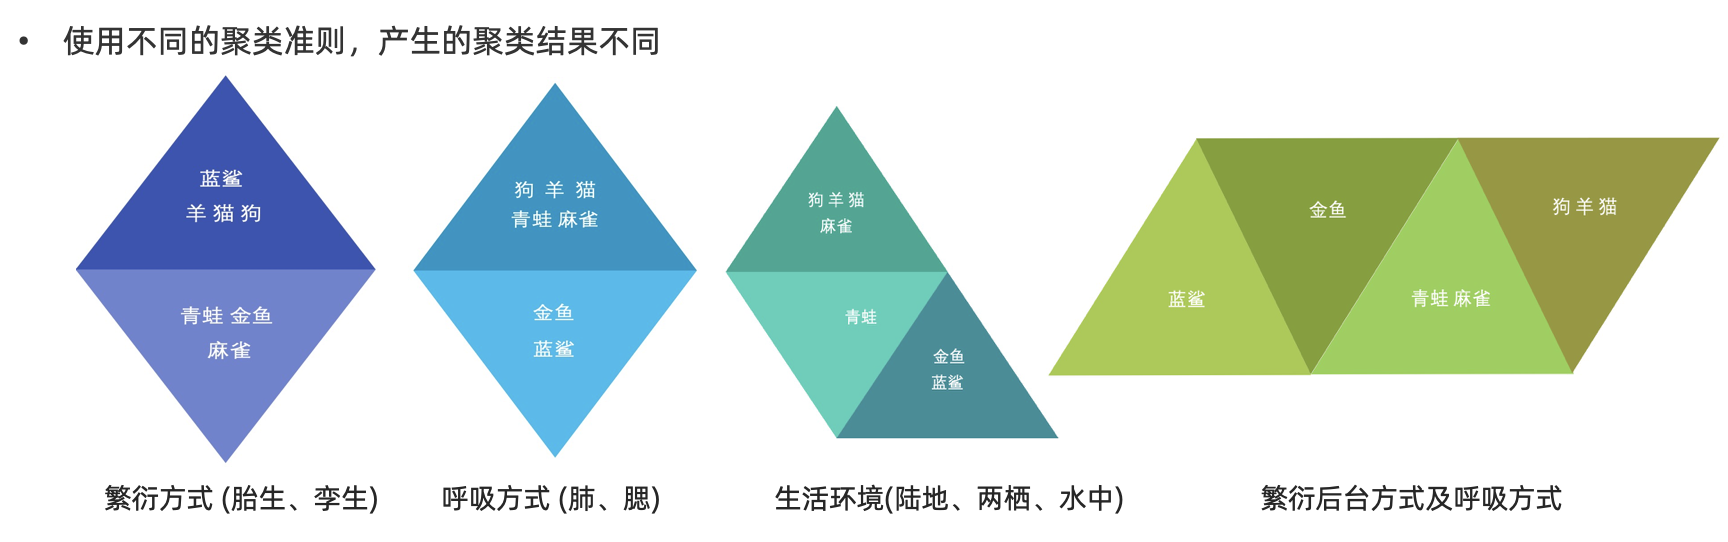
在聚类算法中根据样本之间的相似性,将样本划分到不同的类别中,对于不同的相似度计算方法,会得到不同的聚类结果,常用的相似度计算方法有欧式距离法。
【了解】聚类算法在现实中的应用
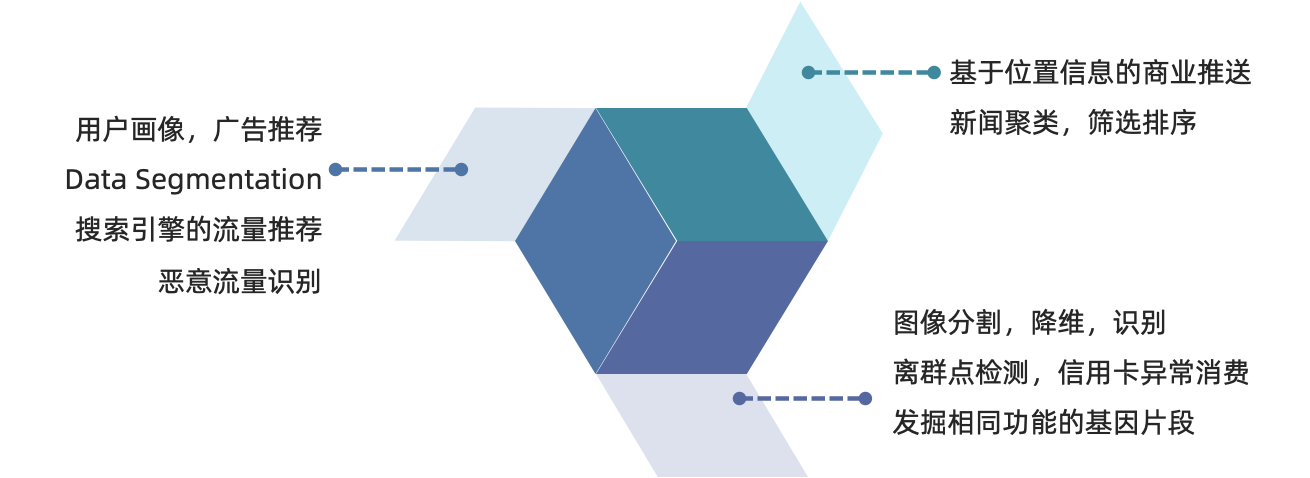
- 用户画像,广告推荐,Data Segmentation,搜索引擎的流量推荐,恶意流量识别
- 基于位置信息的商业推送,新闻聚类,筛选排序
- 图像分割,降维,识别;离群点检测;信用卡异常消费;发掘相同功能的基因片段
【知道】分类
聚类API的初步使用
学习目标:
1.了解Kmeans算法的API
2.动手实践Kmeans算法
【了解】api介绍
- sklearn.cluster.KMeans(n_clusters=8)
- 参数:
- n_clusters:开始的聚类中心数量
- 整型,缺省值=8,生成的聚类数,即产生的质心(centroids)数。
- 方法:
- estimator.fit(x)
- estimator.predict(x)
- estimator.fit_predict(x)
- 计算聚类中心并预测每个样本属于哪个类别,相当于先调用fit(x),然后再调用predict(x)
【实践】 案例
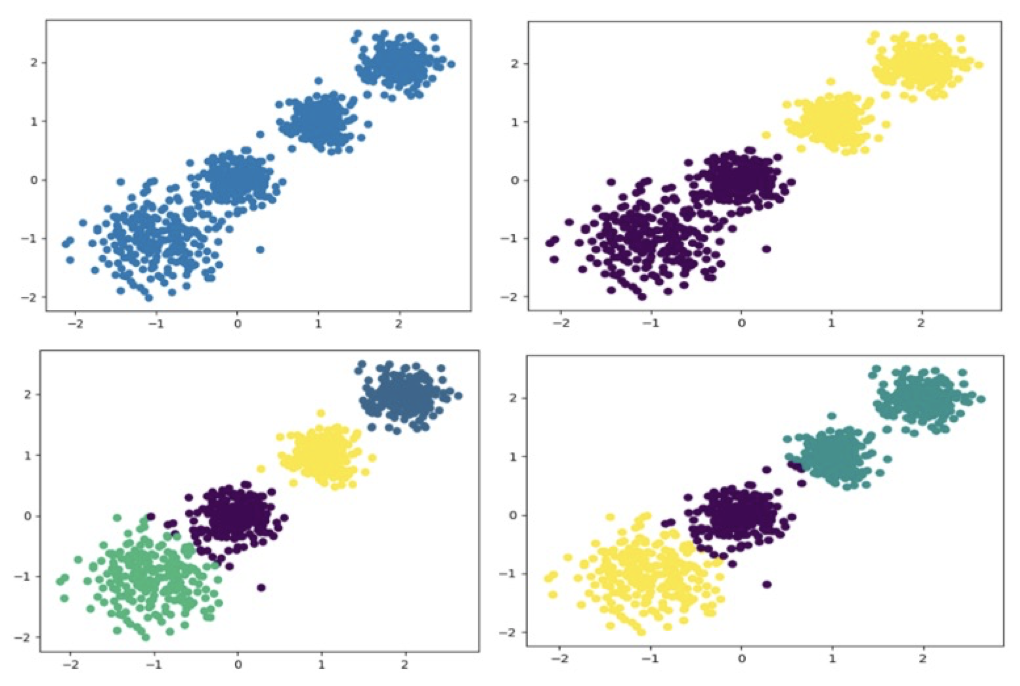
随机创建不同二维数据集作为训练集,并结合k-means算法将其聚类,你可以尝试分别聚类不同数量的簇,并观察聚类效果:
1.创建数据集
import matplotlib.pyplot as plt
from sklearn.datasets.samples_generator import make_blobs
from sklearn.cluster import KMeans
from sklearn.metrics import calinski_harabaz_score

# 创建数据集
# X为样本特征,Y为样本簇类别, 共1000个样本,每个样本2个特征,共4个簇,
# 簇中心在[-1,-1], [0,0],[1,1], [2,2], 簇方差分别为[0.4, 0.2, 0.2, 0.2]
X, y = make_blobs(n_samples=1000, n_features=2, centers=[[-1, -1], [0, 0], [1, 1], [2, 2]],
                  cluster_std=[0.4, 0.2, 0.2, 0.2],
                  random_state=9)

# 数据集可视化
plt.scatter(X[:, 0], X[:, 1], marker='o')
plt.show()
2.使用k-means进行聚类,并使用CH方法评估
y_pred = KMeans(n_clusters=2, random_state=9).fit_predict(X)
# 分别尝试n_cluses=2\3\4,然后查看聚类效果
plt.scatter(X[:, 0], X[:, 1], c=y_pred)
plt.show()

# 用Calinski-Harabasz Index评估的聚类分数
print(calinski_harabasz_score(X, y_pred))
Kmeans算法流程
学习目标
1、理解Kmeans算法的执行过程
【掌握】k-means聚类流程
1、随机设置K个特征空间内的点作为初始的聚类中心
2、对于其他每个点计算到K个中心的距离,未知的点选择最近的一个聚类中心点作为标记类别
3、接着对着标记的聚类中心之后,重新计算出每个聚类的新中心点(平均值)
4、如果计算得出的新中心点与原中心点一样(质心不再移动),那么结束,否则重新进行第二步过程
通过下图解释实现流程:
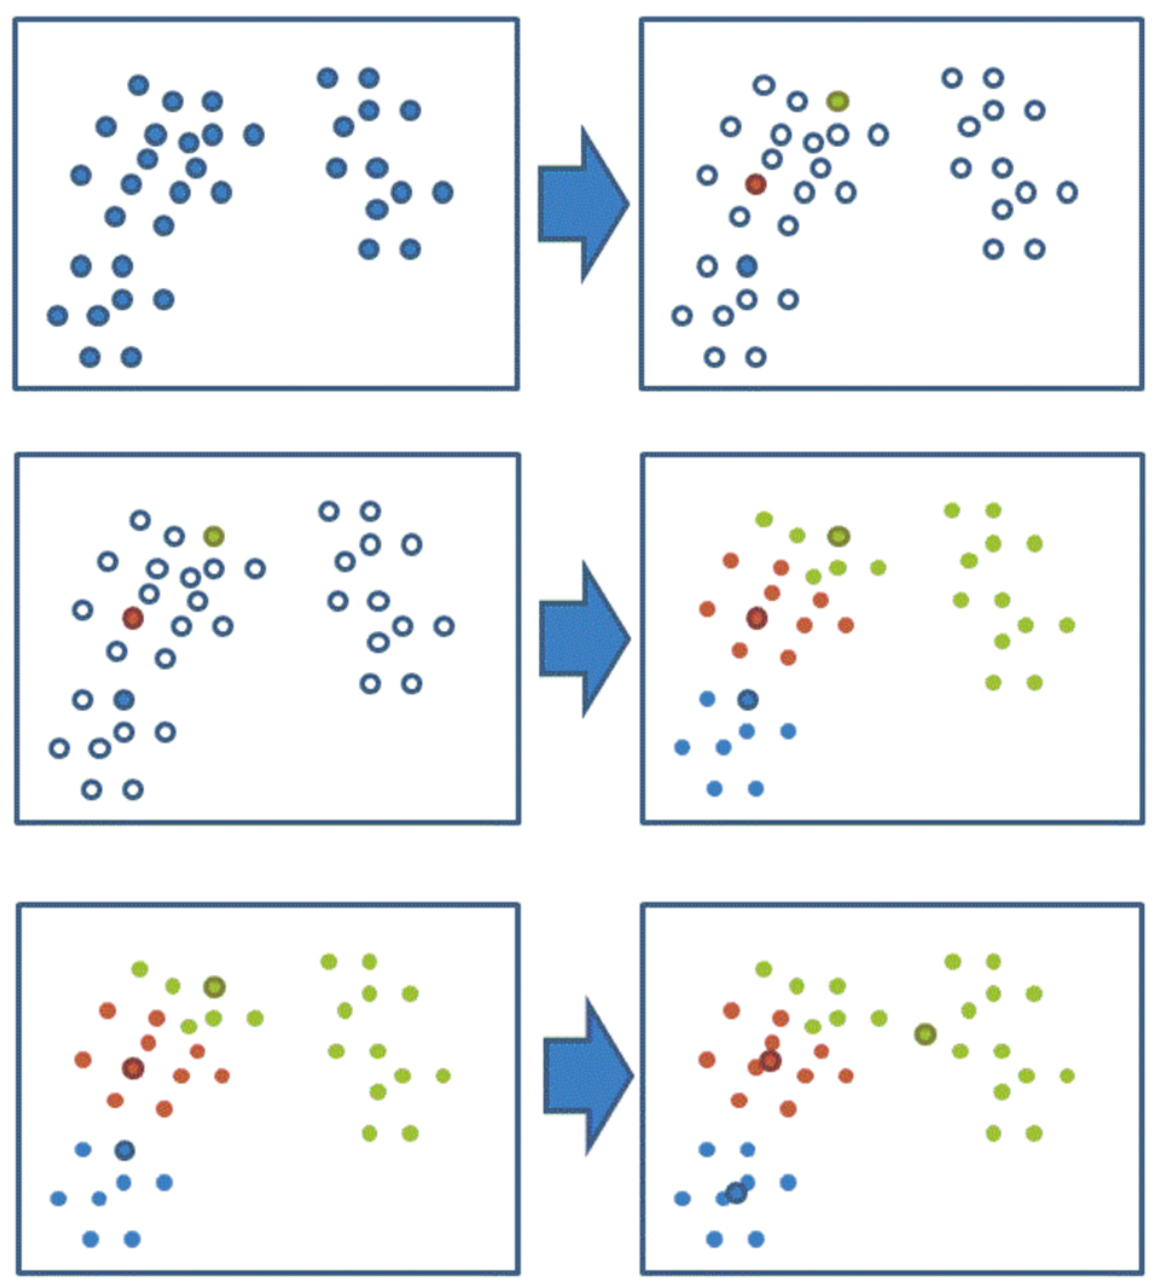
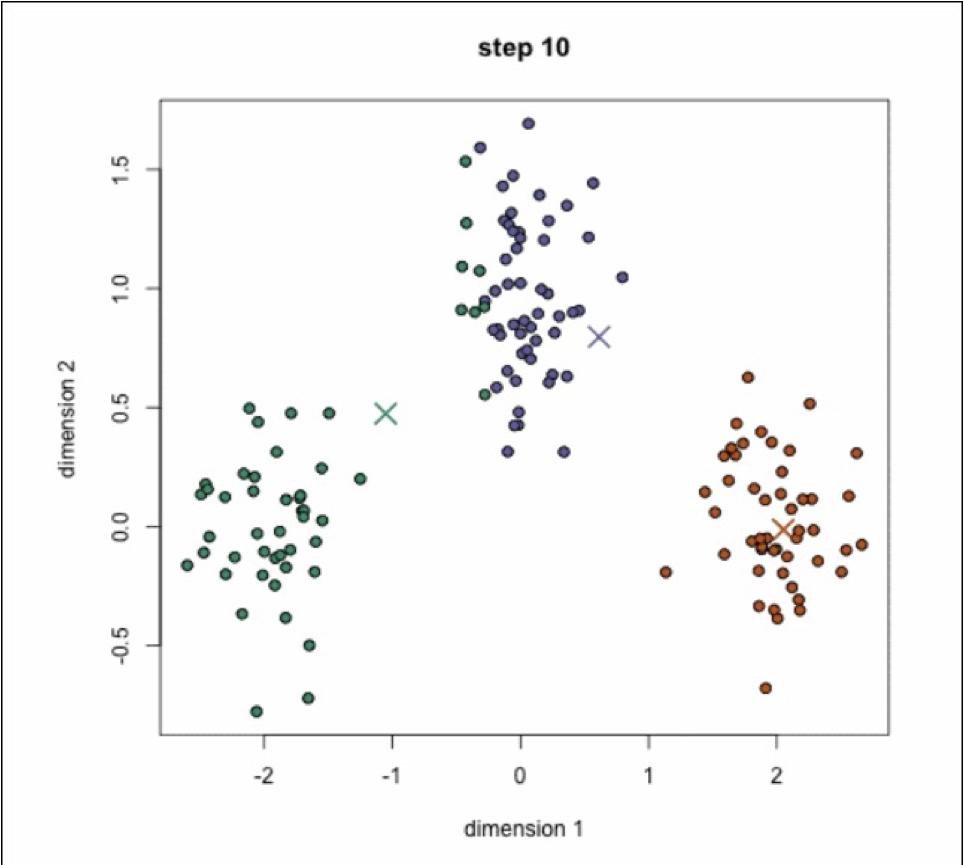
k-means聚类动态效果图:
评价指标
学习目标:
- 了解 SSE 聚类评估指标
- 了解 SC 聚类评估指标
- 了解 CH 聚类评估指标
- 了解肘方法的作用
【了解】 SSE-误差平方和
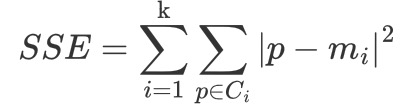
-
K 表示聚类中心的个数
-
Ci 表示簇
-
p 表示样本
-
mi 表示簇的质心
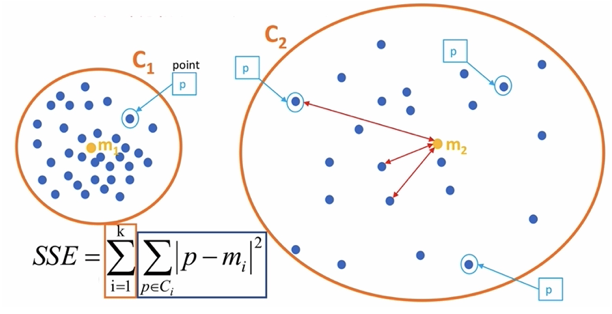
SSE 越小,表示数据点越接近它们的中心,聚类效果越好。
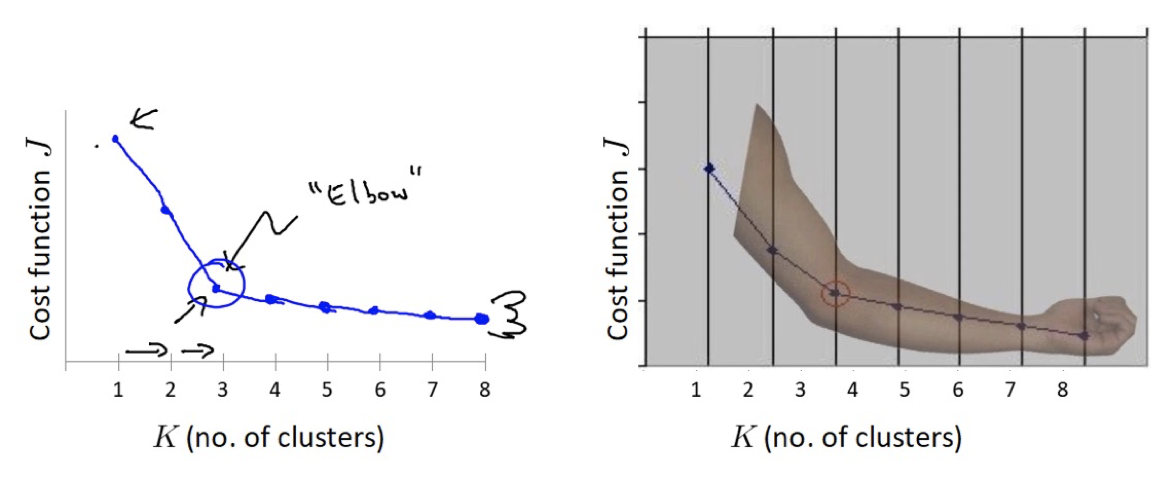
【了解】肘部法
肘部法可以用来确定 K 值.
-
对于n个点的数据集,迭代计算 k from 1 to n,每次聚类完成后计算 SSE
-
SSE 是会逐渐变小的,因为每个点都是它所在的簇中心本身。
-
SSE 变化过程中会出现一个拐点,下降率突然变缓时即认为是最佳 n_clusters 值。
-
在决定什么时候停止训练时,肘形判据同样有效,数据通常有更多的噪音,在增加分类无法带来更多回报时,我们停止增加类别。
【实践】聚类评估的使用
from sklearn.datasets import make_blobs
from sklearn.cluster import KMeans
import matplotlib.pyplot as plt


if __name__ == '__main__':
    x, y = make_blobs(n_samples=1000,
                      n_features=2,
                      centers=[[-1, -1], [0, 0], [1, 1], [2, 2]],
                      cluster_std=[0.4, 0.2, 0.2, 0.2],
                      random_state=9)

    plt.figure(figsize=(18, 8), dpi=80)
    plt.scatter(x[:, 0], x[:, 1], c=y)
    plt.show()

    estimator = KMeans(n_clusters=4, random_state=0)
    estimator.fit(x)
    y_pred = estimator.predict(x)

    #  计算 SSE 值
    print('SSE:', estimator.inertia_)
【实践】案例
【了解】案例介绍
已知:客户性别、年龄、年收入、消费指数
需求:对客户进行分析,找到业务突破口,寻找黄金客户
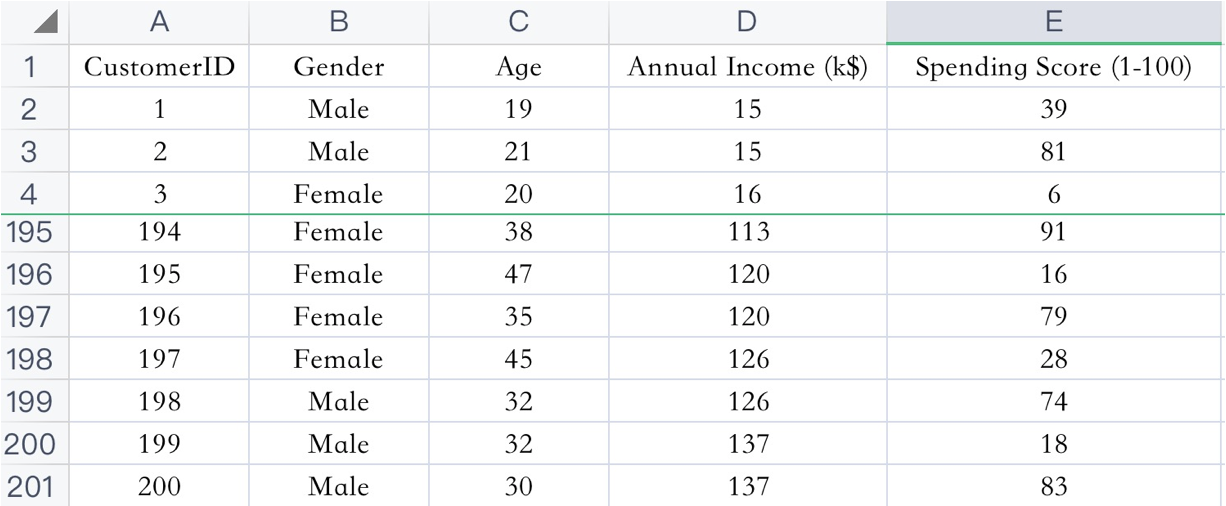
数据集共包含顾客的数据, 数据共有 4 个特征, 数据共有 200 条。接下来,使用聚类算法对具有相似特征的的顾客进行聚类,并可视化聚类结果。
【实践】案例实现
import matplotlib.colors
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
import pandas as pd
from sklearn.manifold import TSNE
from sklearn.preprocessing import StandardScaler


pd.set_option('display.max_columns', None)
pd.set_option('display.max_rows', None)
pd.set_option('display.width', 1000)


if __name__ == '__main__':

    # 1. 读取顾客数据
    data = pd.read_csv('data/customers.csv')
    data.columns = ['CustomerID', 'Gender', 'Age', 'Annual Income', 'Spending Score']
    # print(data.head())

    # 2. 对 Gender 特征进行独热编码
    data = pd.get_dummies(data, columns=['Gender'])
    # print(data.head())

    # 3. 数据标准化
    scaler = StandardScaler()
    data = scaler.fit_transform(data)
    print(data)

    # 4. 去除非 ID 列进行聚类分析
    data = data[:, 1:]
    # print(data[:5])

    # 5. 肘部法寻找质心个数
    sse = []
    for k in range(1, 20):
        estimator = KMeans(n_clusters=k, random_state=0)
        estimator.fit(data)
        sse.append(estimator.inertia_)

    plt.plot(range(1, 20), sse)
    plt.show()

    # 6. 确定质心的个数
    estimator = KMeans(n_clusters=10, n_init=10, random_state=0)
    y_pred = estimator.fit_predict(data)

    # 7. 聚类结果可视化
    plt.scatter(X.values[y_kmeans == 0, 0], X.values[y_kmeans == 0, 1], s=100, c='red', label='Standard')
    plt.scatter(X.values[y_kmeans == 1, 0], X.values[y_kmeans == 1, 1], s=100, c='blue', label='Traditional')
    plt.scatter(X.values[y_kmeans == 2, 0], X.values[y_kmeans == 2, 1], s=100, c='green', label='Normal')
    plt.scatter(X.values[y_kmeans == 3, 0], X.values[y_kmeans == 3, 1], s=100, c='cyan', label='Youth')
    plt.scatter(X.values[y_kmeans == 4, 0], X.values[y_kmeans == 4, 1], s=100, c='magenta', label='TA')
    plt.scatter(mykeans.cluster_centers_[:, 0], mykeans.cluster_centers_[:, 1], s=300, c='black', label='Centroids’)

    plt.title('Clusters of customers')
    plt.xlabel('Annual Income (k$)')
    plt.ylabel('Spending Score (1-100)')
    plt.legend()
    plt.show()
作业
1.使用思维导图总结聚类算法部分的内容
2.动手实现课程中的代码