集成学习
集成学习简介
学习目标:
1.知道集成学习是什么?
2.了解集成学习的分类
3.理解bagging集成的思想
4.理解boosting集成的思想
【知道】集成学习是什么?
集成学习是机器学习中的一种思想,它通过多个模型的组合形成一个精度更高的模型,参与组合的模型成为弱学习器(基学习器)。训练时,使用训练集依次训练出这些弱学习器,对未知的样本进行预测时,使用这些弱学习器联合进行预测。
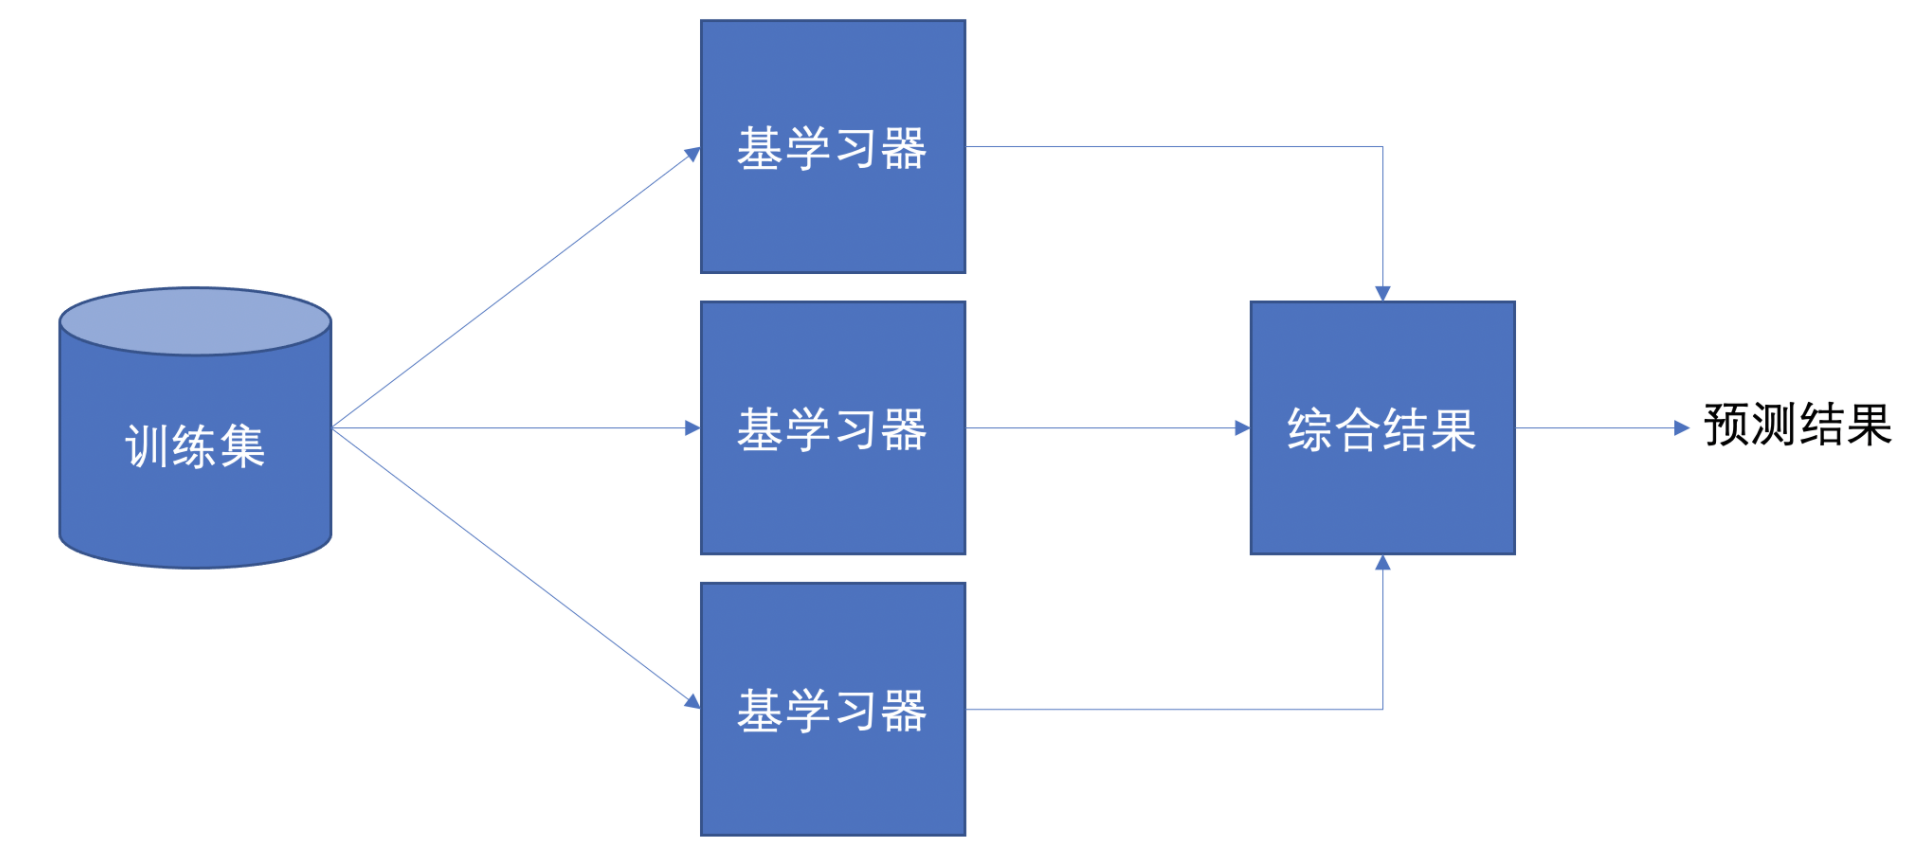
传统机器学习算法 (例如:决策树,逻辑回归等) 的目标都是寻找一个最优分类器尽可能的将训练数据分开。集成学习 (Ensemble Learning) 算法的基本思想就是将多个分类器组合,从而实现一个预测效果更好的集成分类器。集成算法可以说从一方面验证了中国的一句老话:三个臭皮匠,赛过诸葛亮
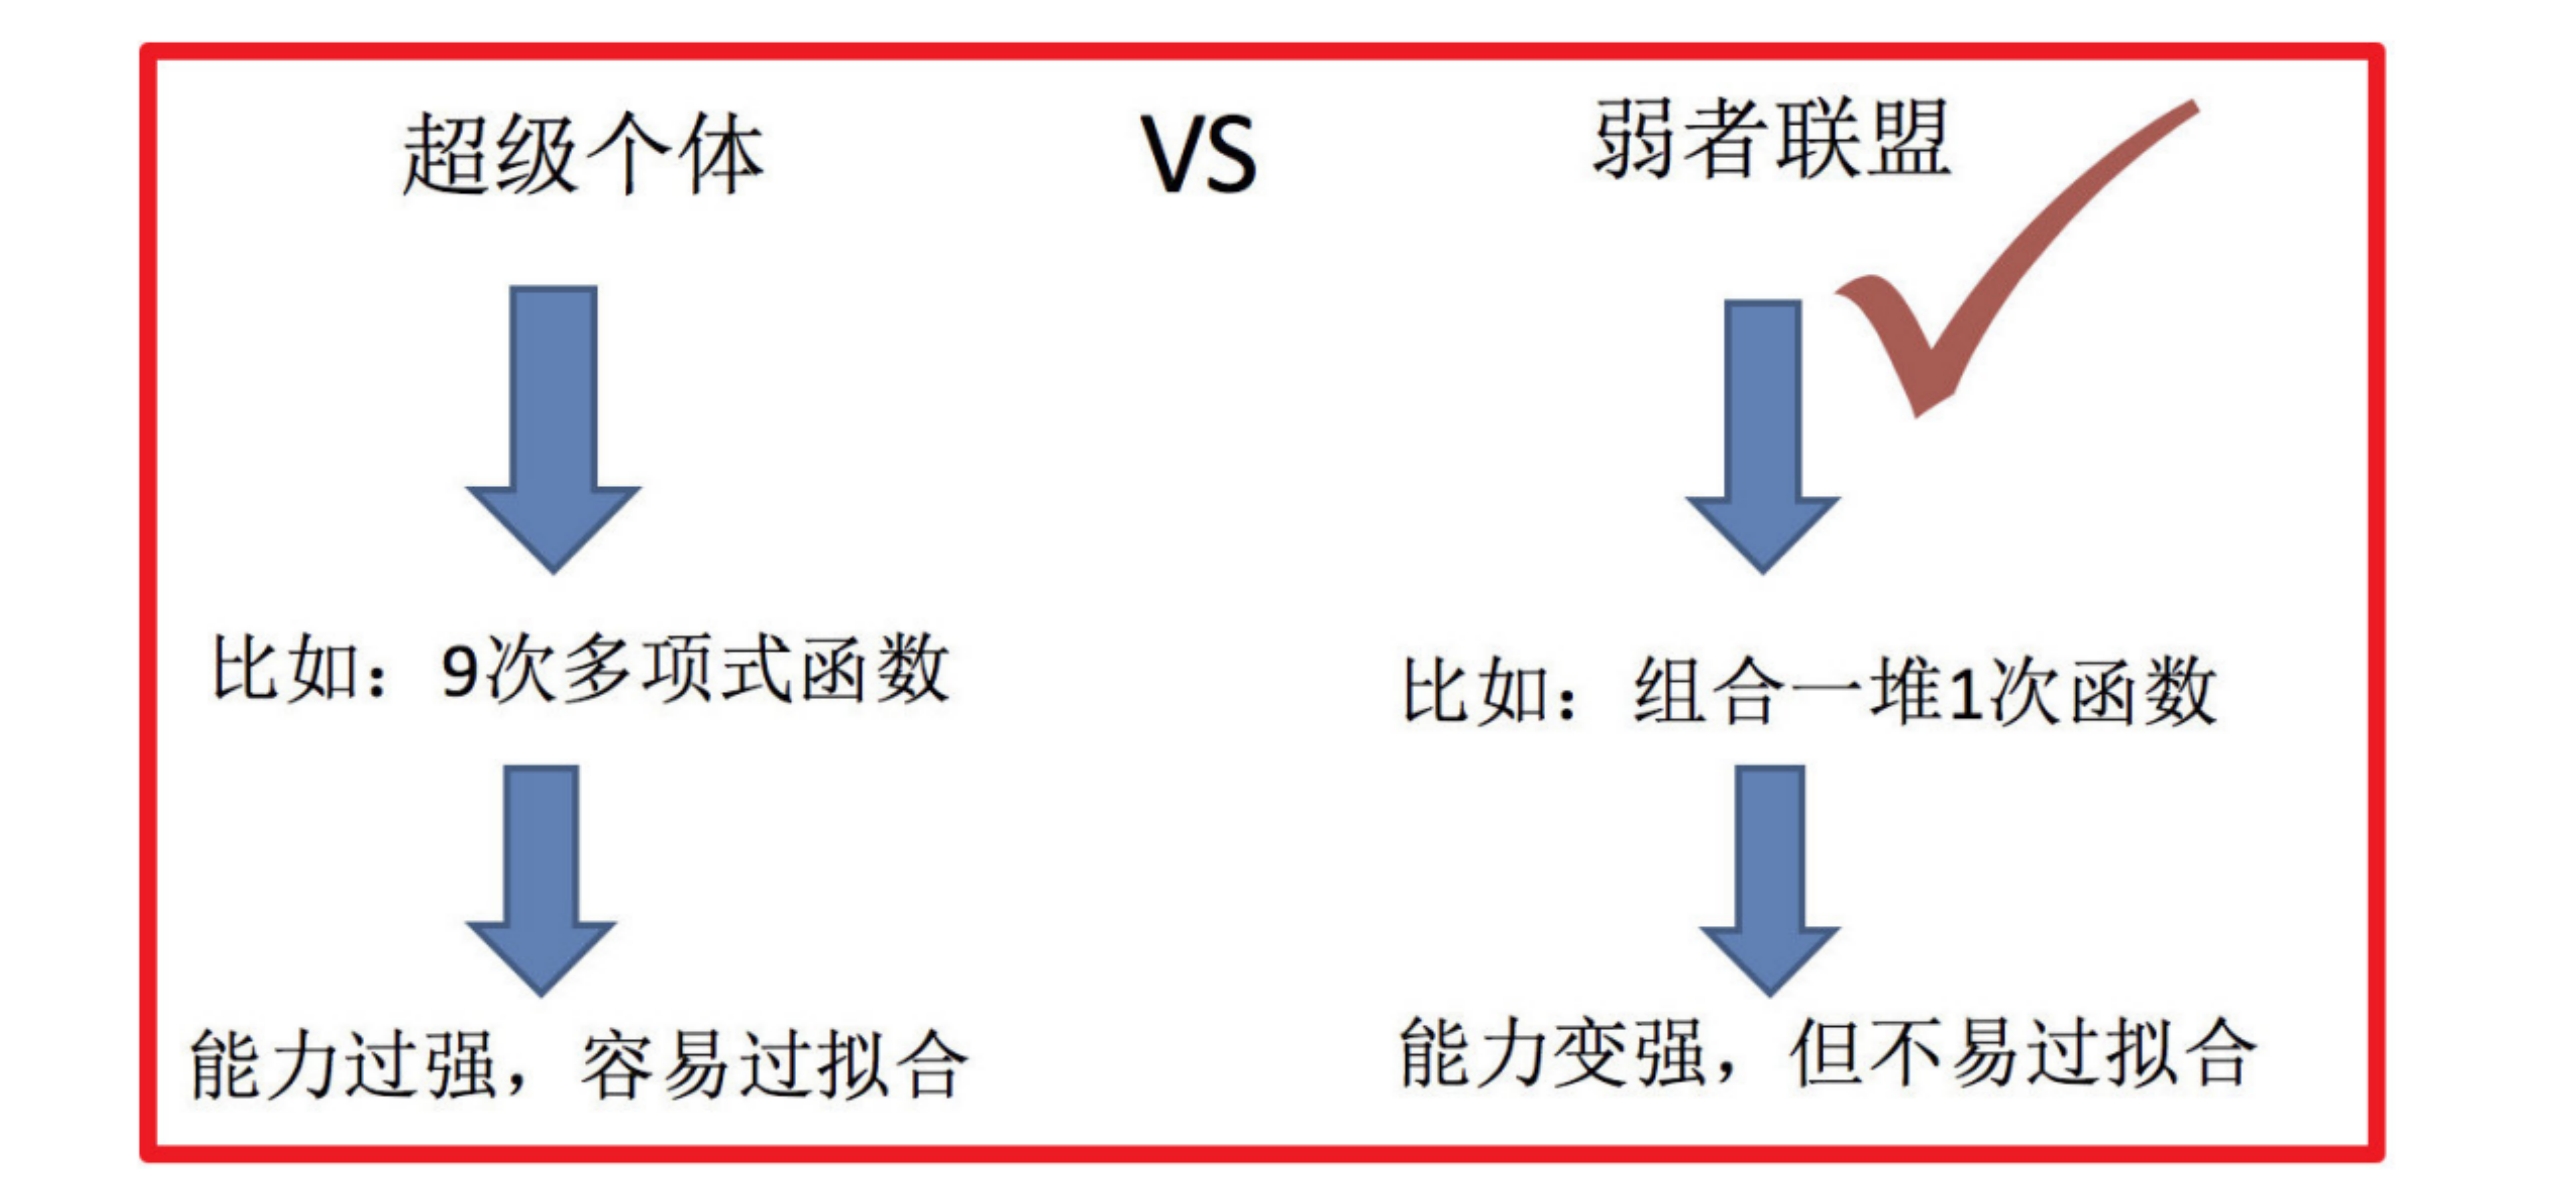
集成学习通过建立几个模型来解决单一预测问题。它的工作原理是 生成多个分类器/模型,各自独立地学习和作出预测。这些预测最后结合成组合预测,因此优于任何一个单分类的做出预测。
【了解】集成学习分类
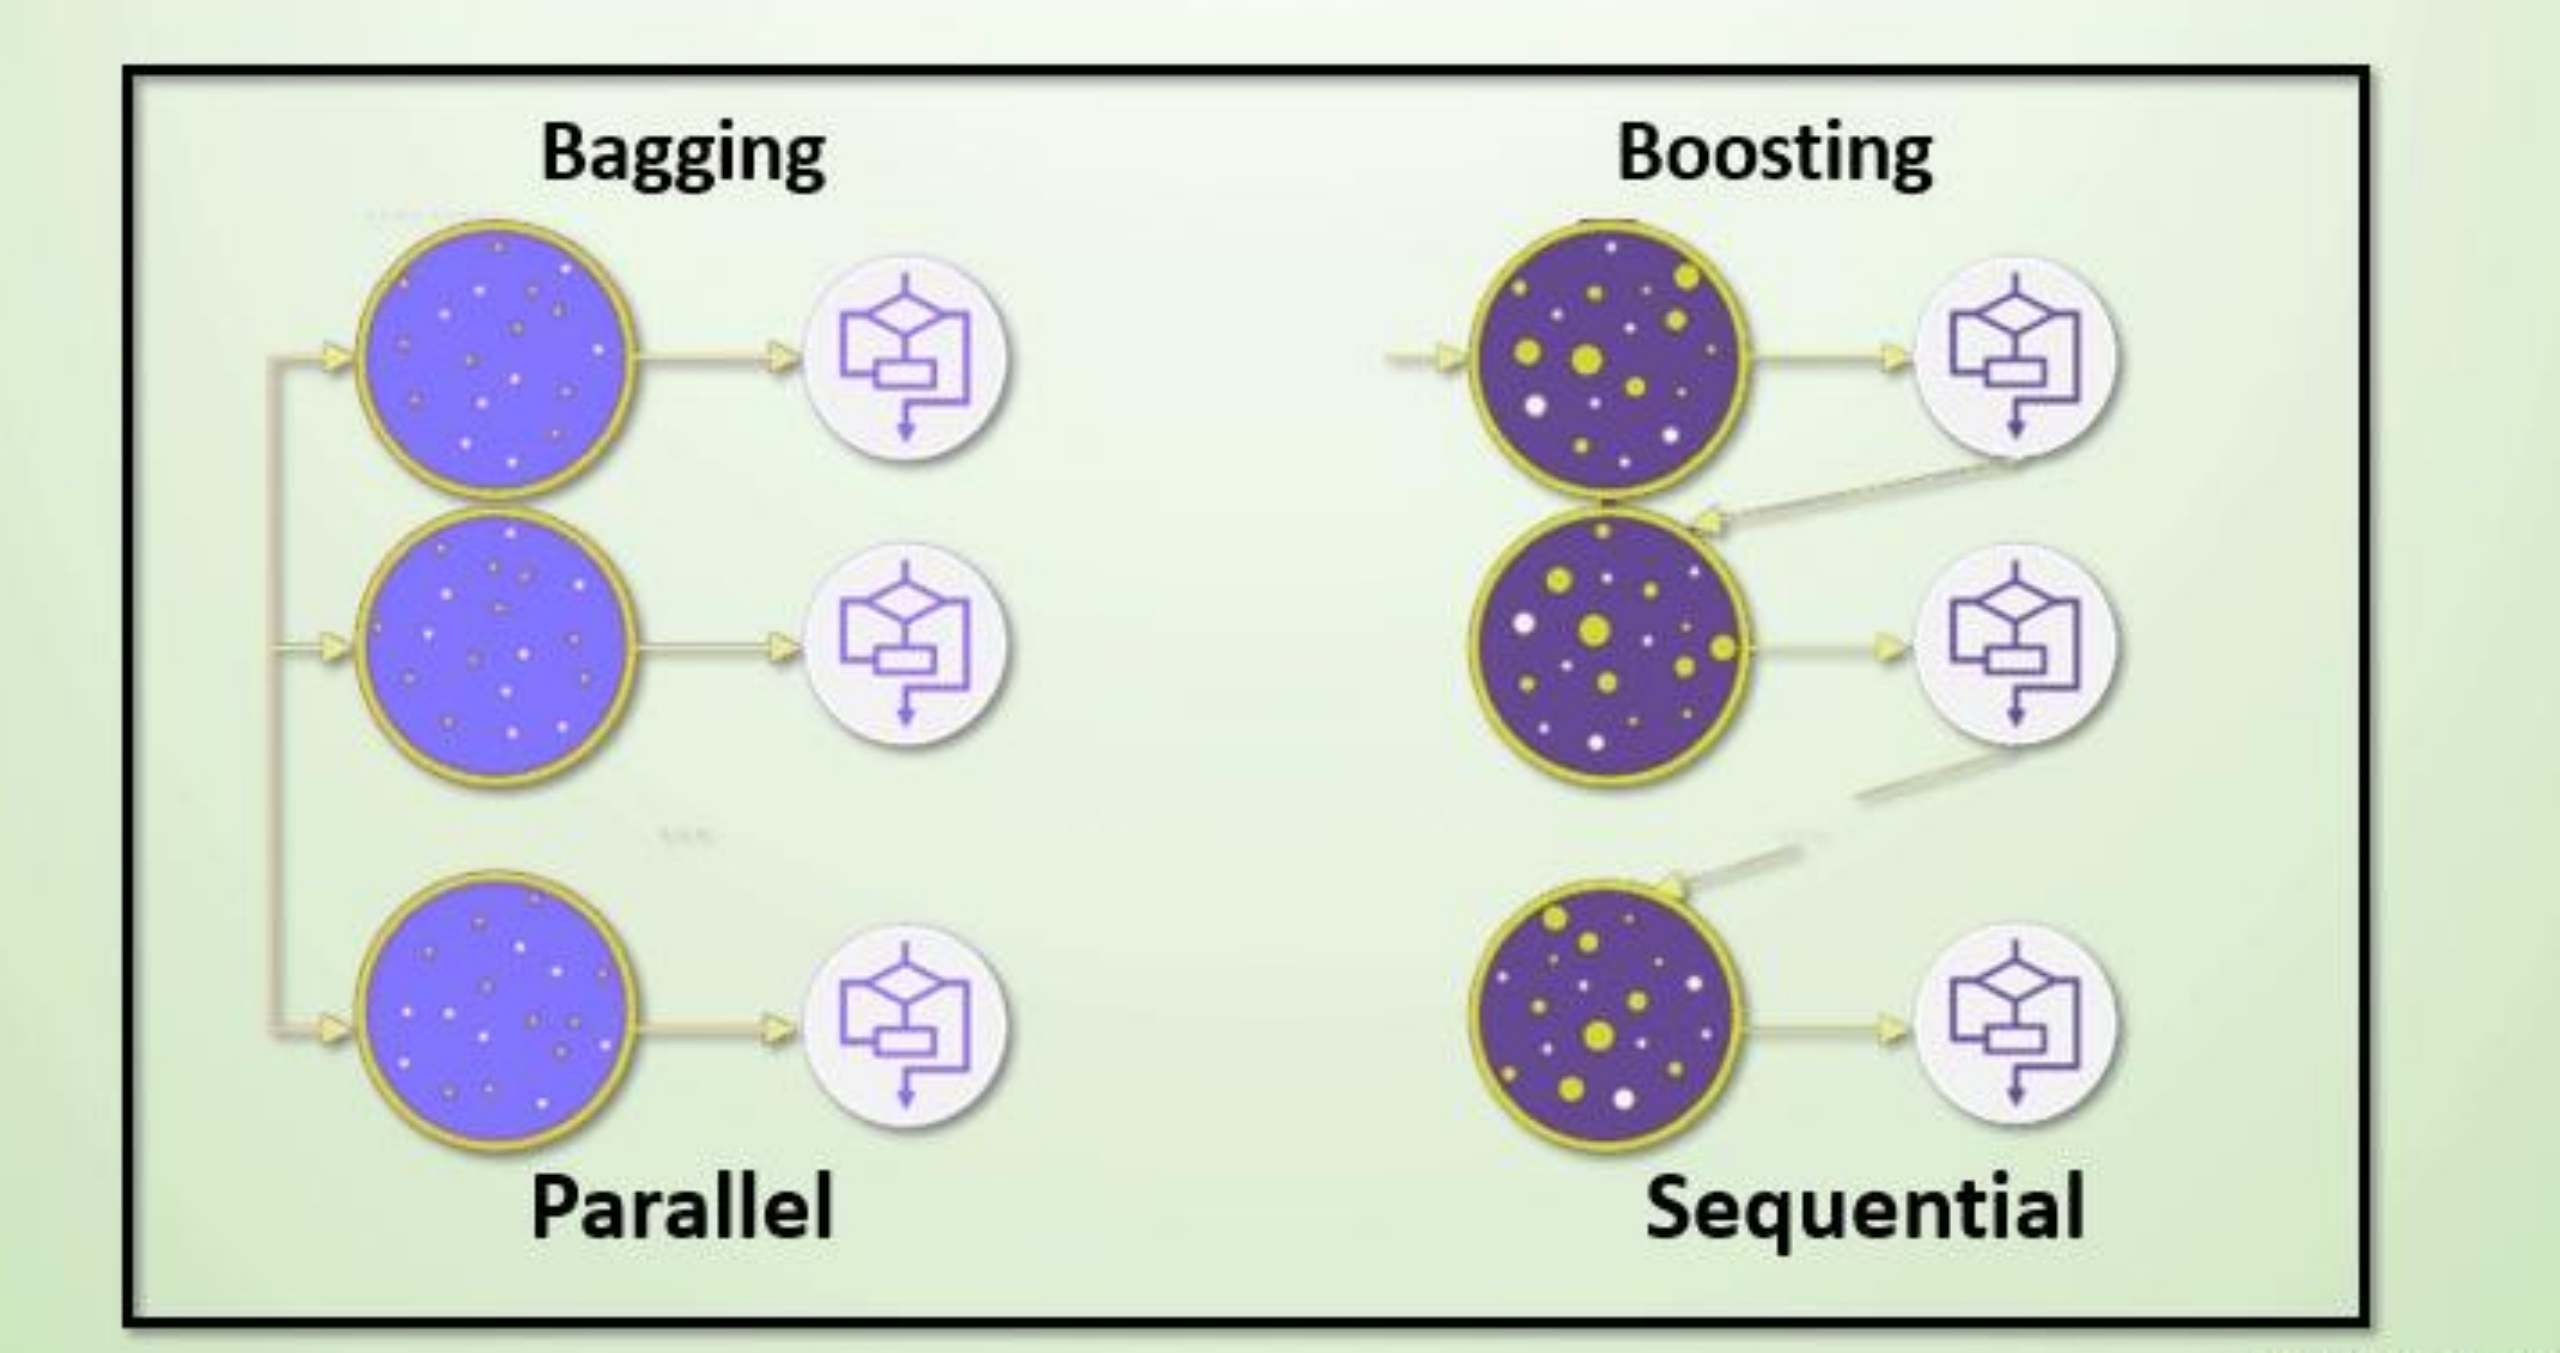
集成学习算法一般分为:bagging和boosting。
【理解】bagging集成
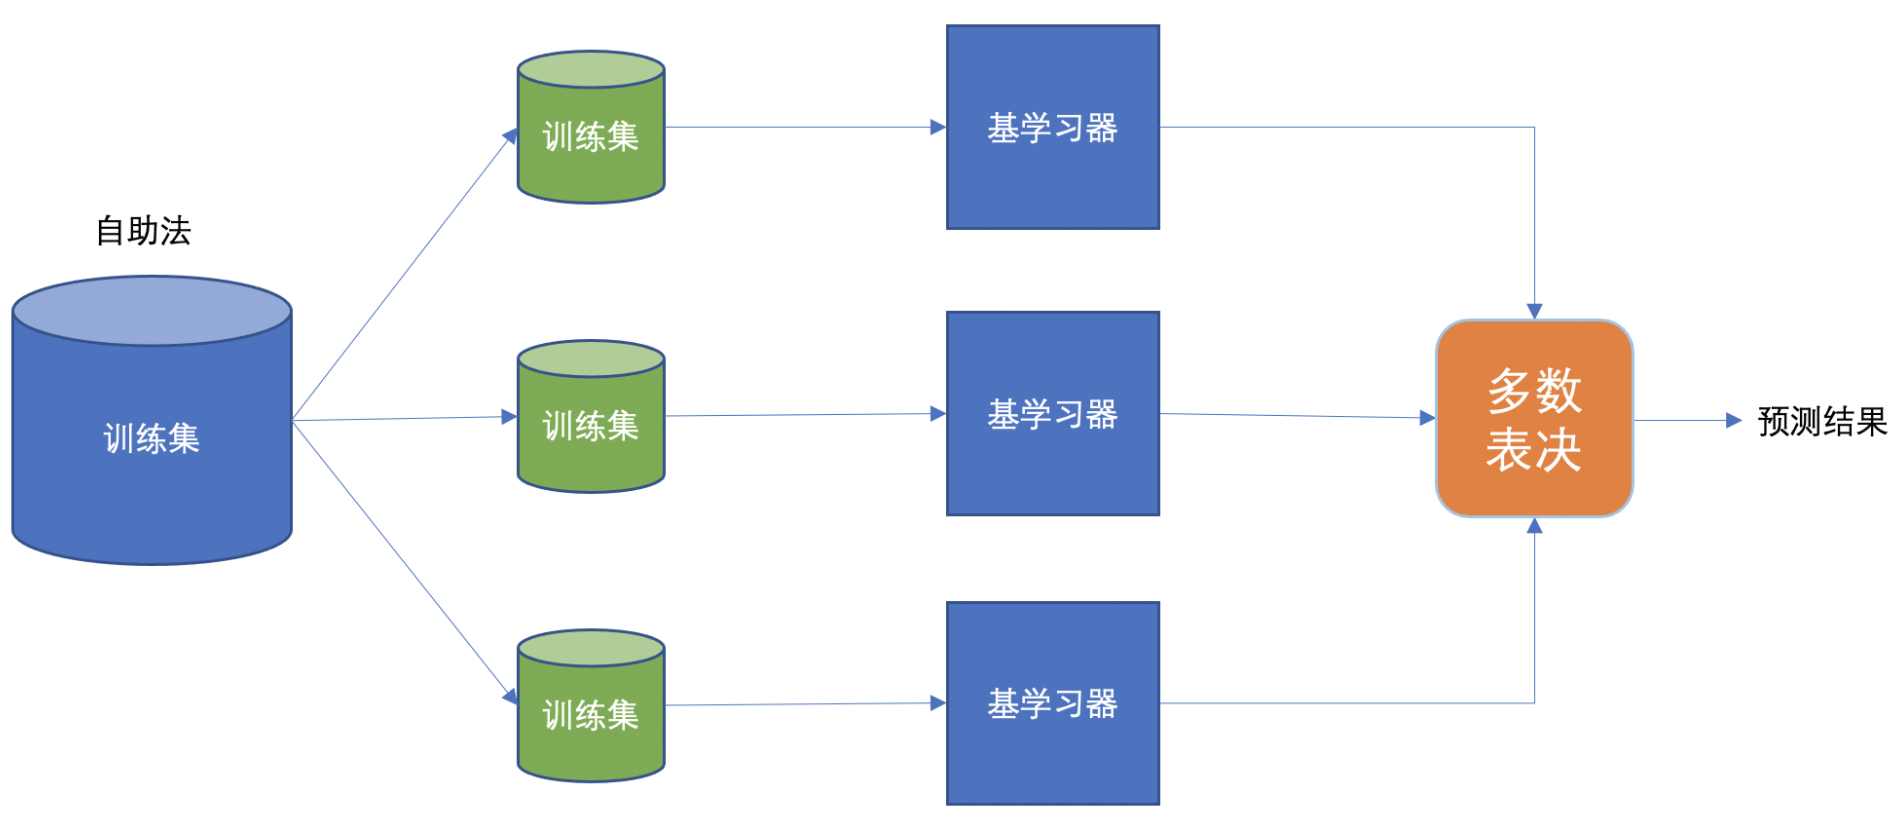
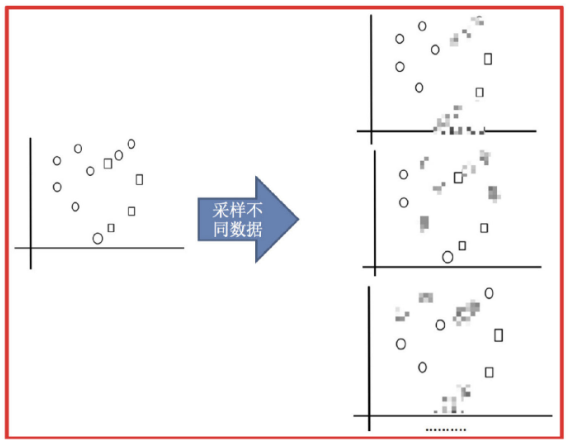
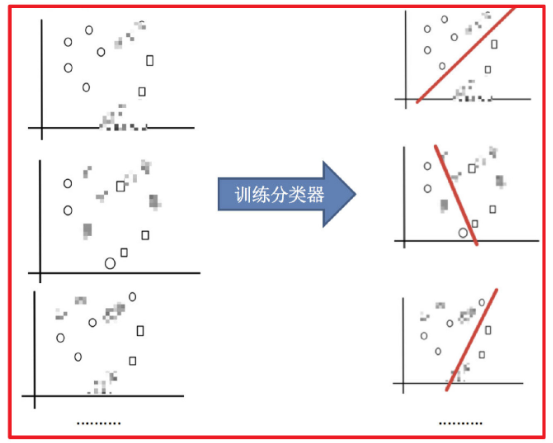
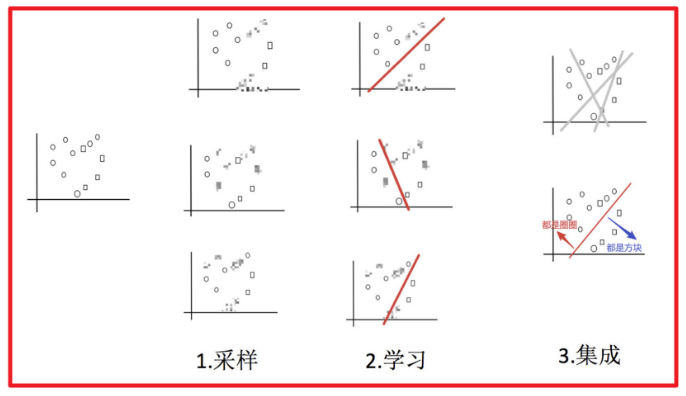
Baggging 框架通过有放回的抽样产生不同的训练集,从而训练具有差异性的弱学习器,然后通过平权投票、多数表决的方式决定预测结果。
例子:
目标:把下面的圈和方块进行分类
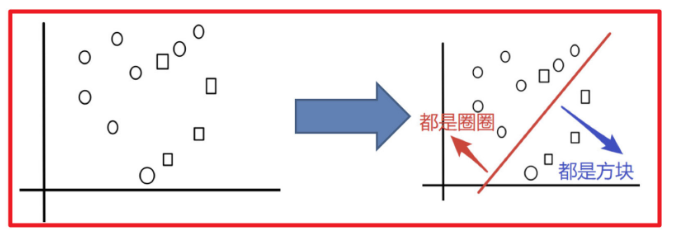
1) 采样不同数据集
2)训练分类器
3)平权投票,获取最终结果
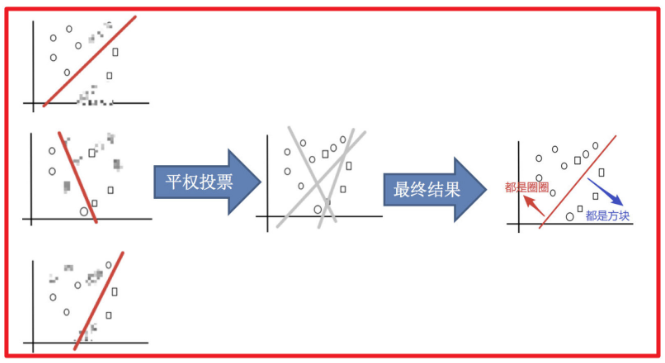
4)主要实现过程小结
【理解】boosting集成
Boosting 体现了提升思想,每一个训练器重点关注前一个训练器不足的地方进行训练,通过加权投票的方式,得出预测结果。
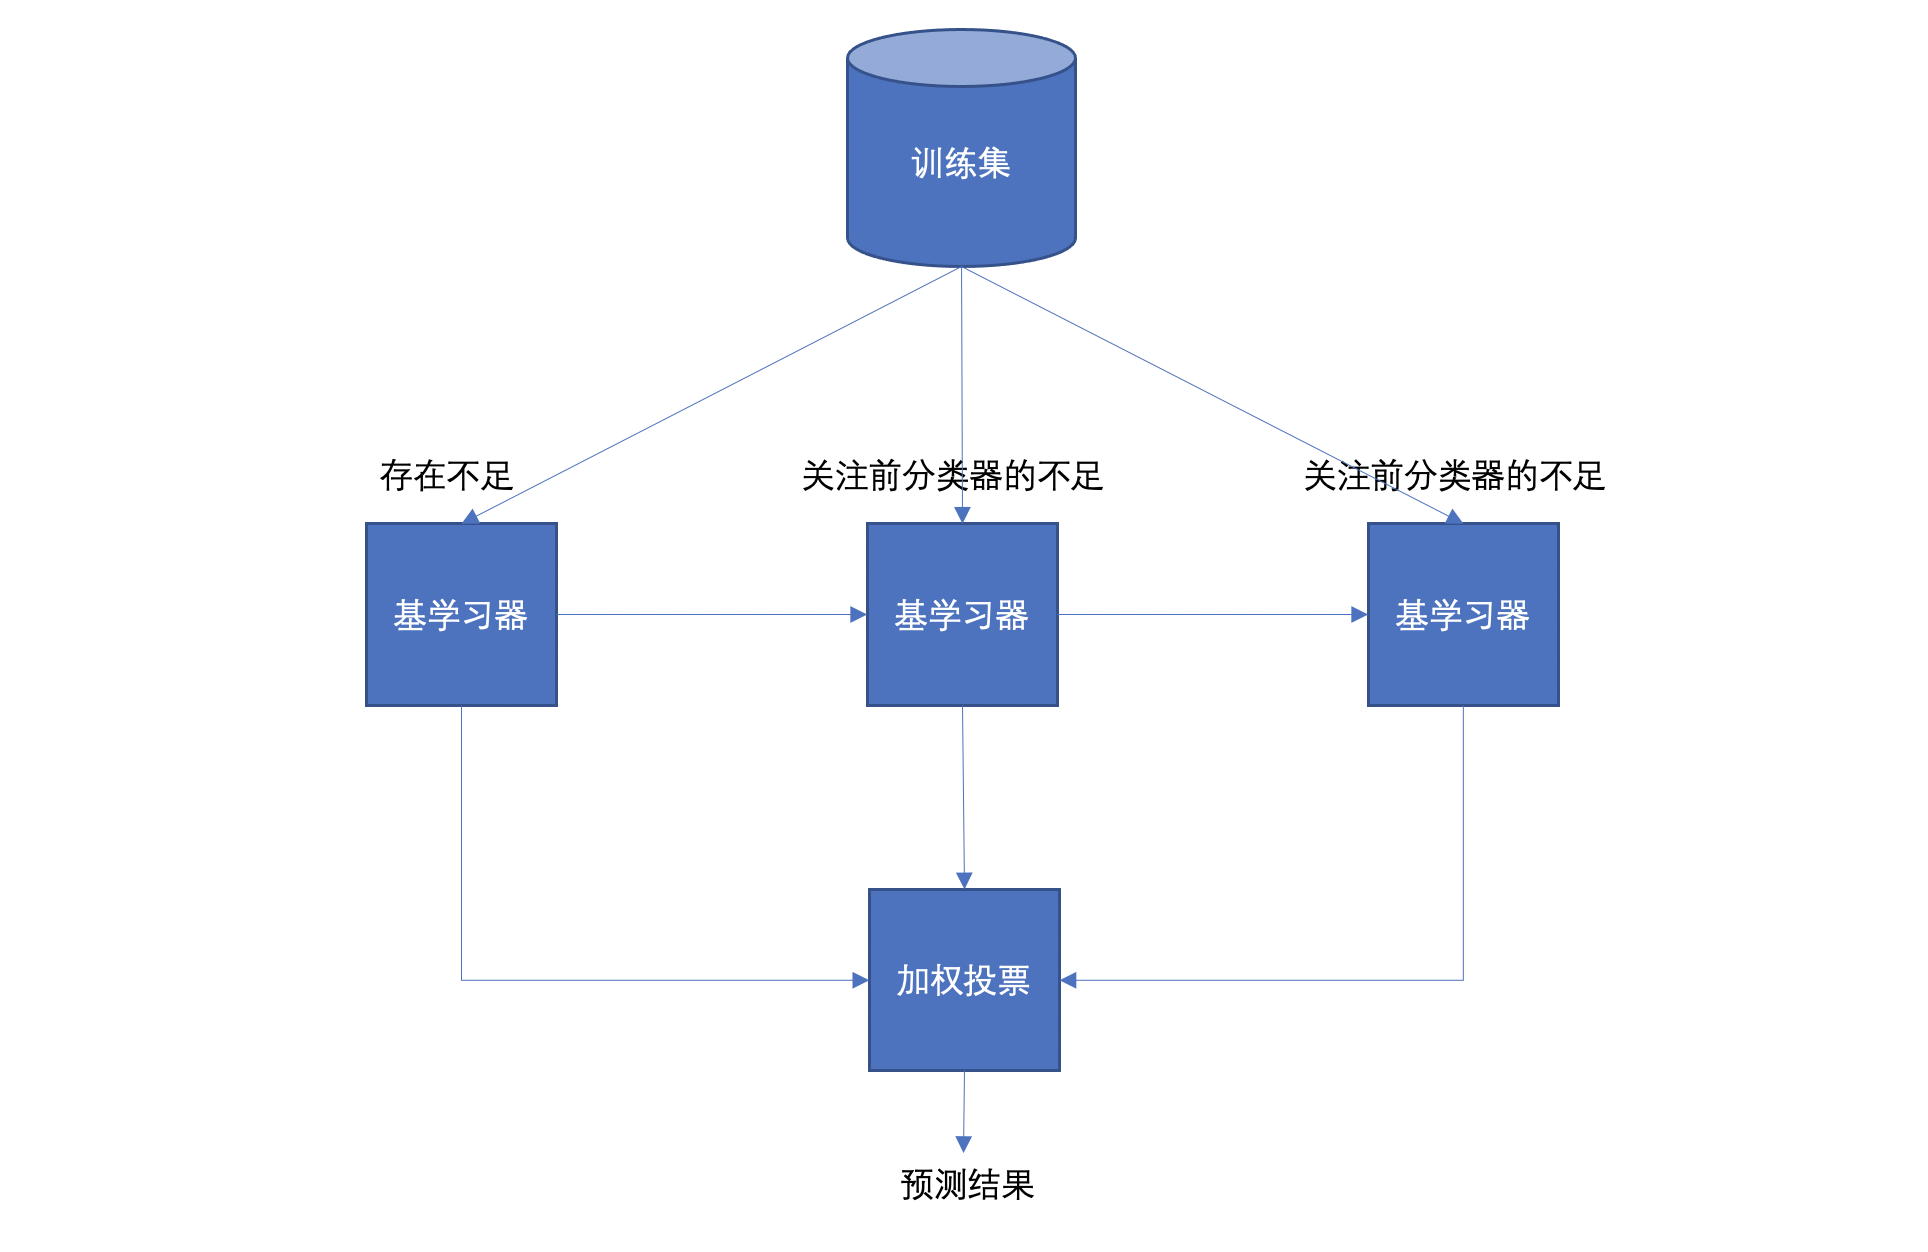
Boosting是一组可将弱学习器升为强学习器算法。这类算法的工作机制类似:
1.先从初始训练集训练出一个基学习器
2.在根据基学习器的表现对训练样本分布进行调整,使得先前基学习器做错的训练样本在后续得到最大的关注。
3.然后基于调整后的样本分布来训练下一个基学习器;
4.如此重复进行,直至基学习器数目达到实现指定的值T为止。
5.再将这T个基学习器进行加权结合得到集成学习器。
简而言之:每新加入一个弱学习器,整体能力就会得到提升
Bagging 与 Boosting
区别一:数据方面
- Bagging:有放回采样
- Boosting:全部数据集, 重点关注前一个弱学习器不足
区别二:投票方面
- Bagging:平权投票
- Boosting:加权投票
区别三:学习顺序
- Bagging的学习是并行的,每个学习器没有依赖关系
- Boosting学习是串行,学习有先后顺序
随机森林
学习目标:
1.理解随机森林的构建方法
2.知道随机森林的API
3.能够使用随机森林完成分类任务
【理解】算法思想
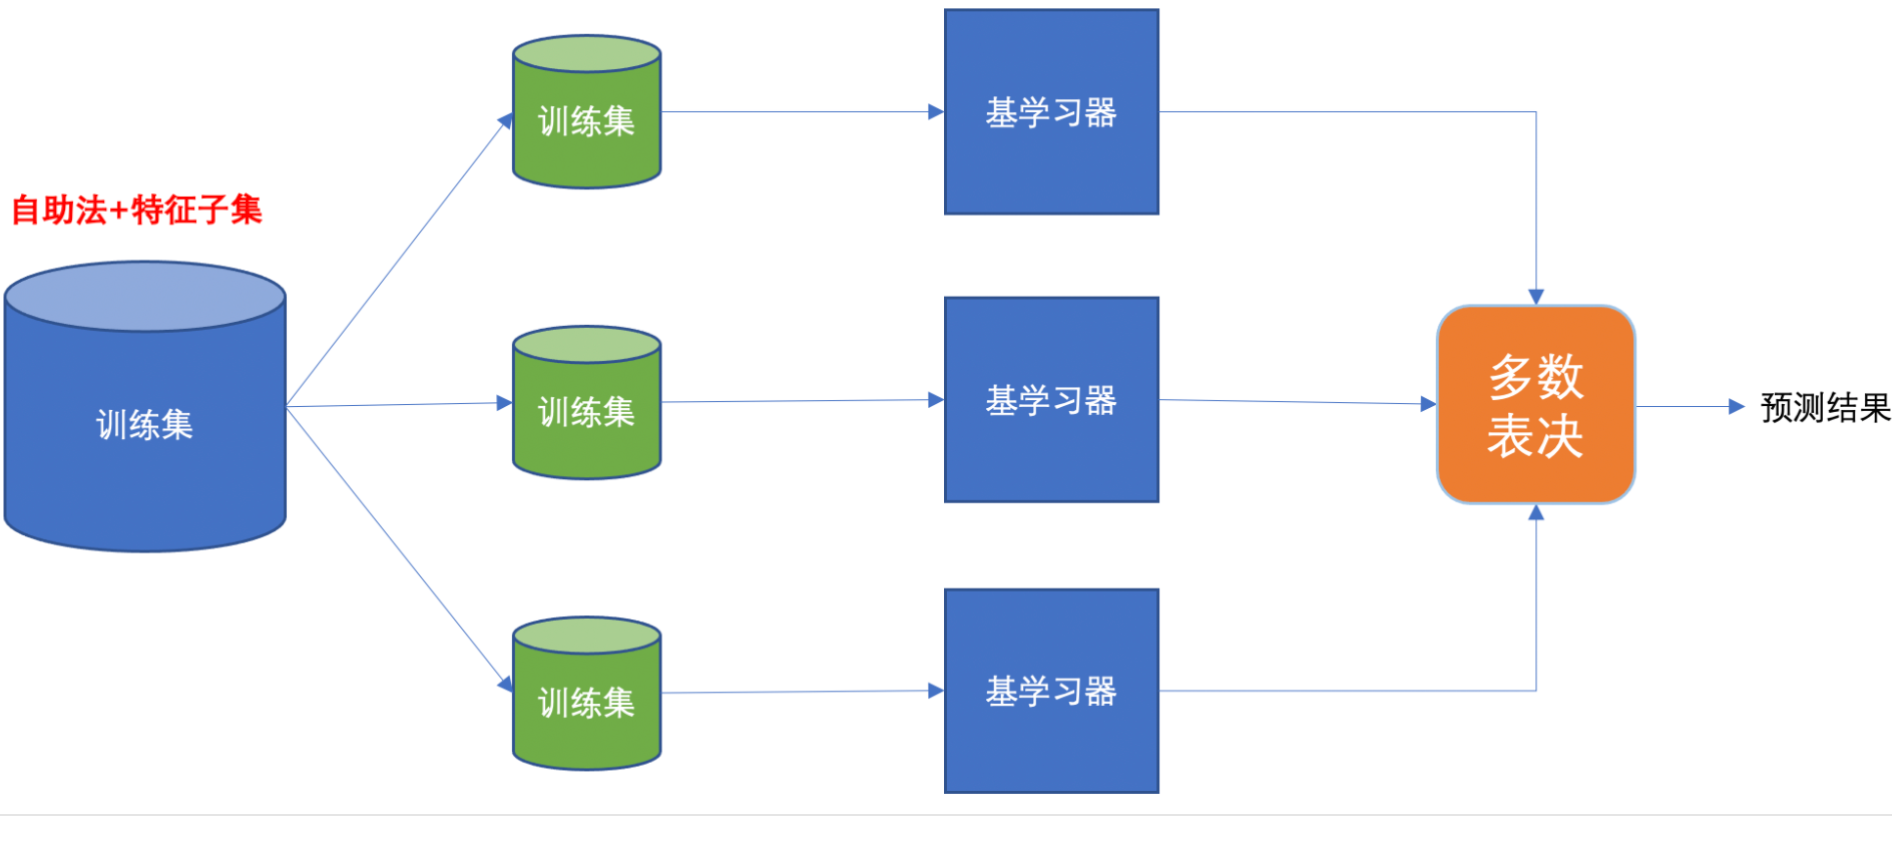
随机森林是基于 Bagging 思想实现的一种集成学习算法,它采用决策树模型作为每一个基学习器。其构造过程:
- 训练:
- 有放回的产生训练样本
- 随机挑选 n 个特征(n 小于总特征数量)
- 预测:平权投票,多数表决输出预测结果
随机森林的步骤
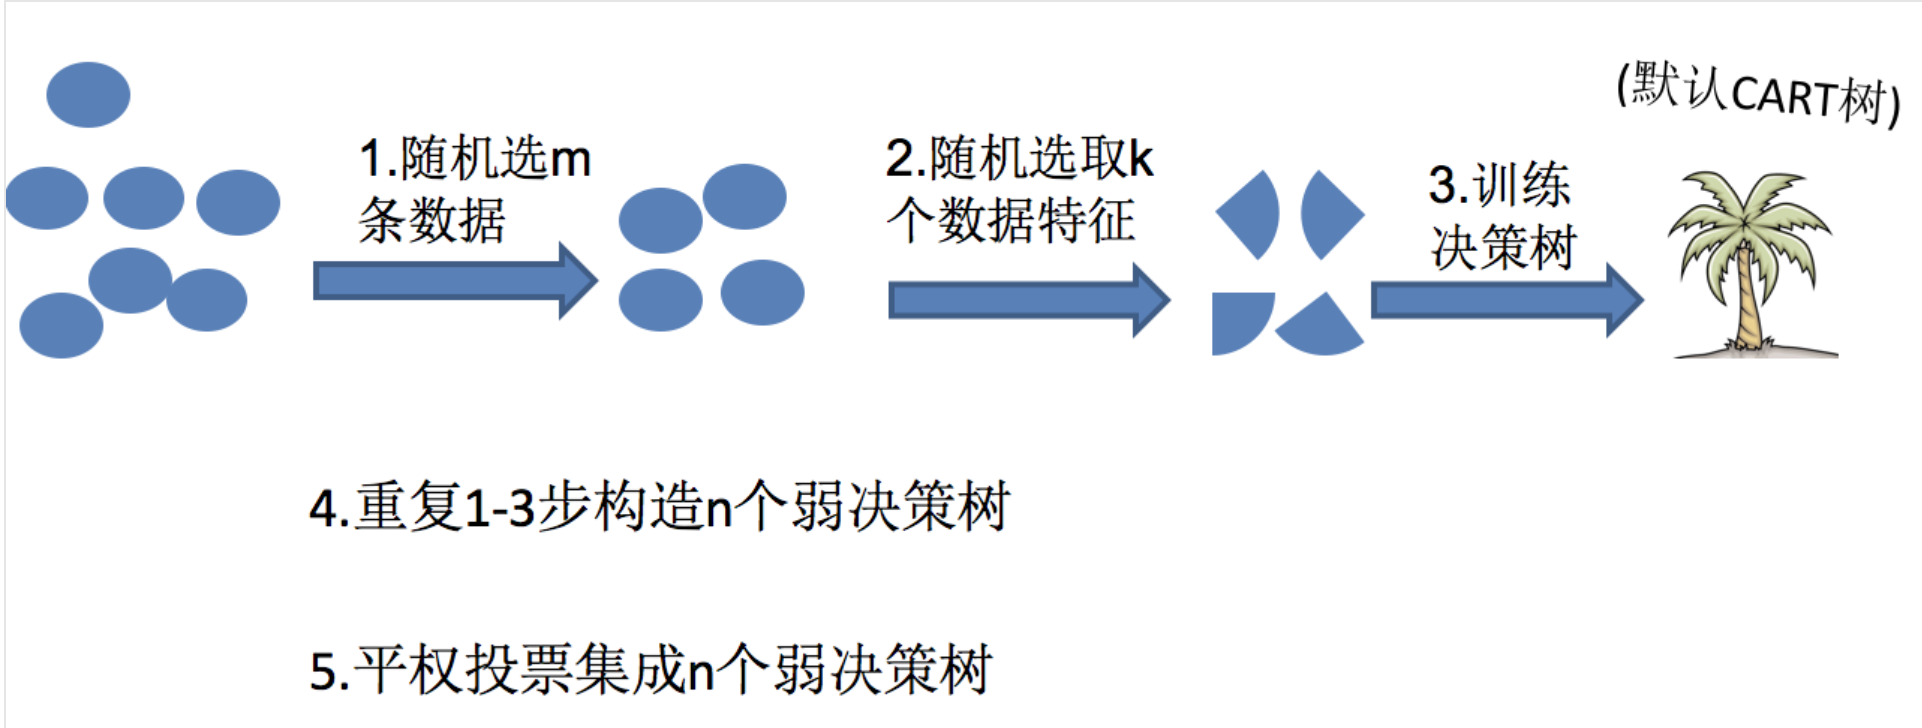
如上图:
首先,对样本数据进行有放回的抽样,得到多个样本集。具体来讲就是每次从原来的N个训练样本中有放回地随机抽取m个样本(包括可能重复样本)。
然后,从候选的特征中随机抽取k个特征,作为当前节点下决策的备选特征,从这些特征中选择最好地划分训练样本的特征。用每个样本集作为训练样本构造决策树。单个决策树在产生样本集和确定特征后,使用CART算法计算,不剪枝。
最后,得到所需数目的决策树后,随机森林方法对这些树的输出进行投票,以得票最多的类作为随机森林的决策。
说明:
(1)随机森林的方法即对训练样本进行了采样,又对特征进行了采样,充分保证了所构建的每个树之间的独立性,使得投票结果更准确。
(2)随机森林的随机性体现在每棵树的训练样本是随机的,树中每个节点的分裂属性也是随机选择的。有了这2个随机因素,即使每棵决策树没有进行剪枝,随机森林也不会产生过拟合的现象。
随机森林中有两个可控制参数:
-
森林中树的数量(一般选取值较大)
-
抽取的属性值m的大小。
思考
- 为什么要随机抽样训练集?
如果不进行随机抽样,每棵树的训练集都一样,那么最终训练出的树分类结果也是完全一样。
- 为什么要有放回地抽样?
如果不是有放回的抽样,那么每棵树的训练样本都是不同的,都是没有交集的,这样每棵树都是“有偏的”,都是绝对“片面的”,也就是说每棵树训练出来都是有很大的差异的;而随机森林最后分类取决于多棵树(弱分类器)的投票表决。
【知道】随机森林 API
sklearn.ensemble.RandomForestClassifier()
n_estimators:决策树数量,(default = 10)
Criterion:entropy、或者 gini, (default = gini)
max_depth:指定树的最大深度,(default = None 表示树会尽可能的生长)
max_features=”auto”, 决策树构建时使用的最大特征数量
- If “auto”, then
max_features=sqrt(n_features). - If “sqrt”, then
max_features=sqrt(n_features)(same as “auto”). - If “log2”, then
max_features=log2(n_features). - If None, then
max_features=n_features.
bootstrap:是否采用有放回抽样,如果为 False 将会使用全部训练样本,(default = True)
min_samples_split: 结点分裂所需最小样本数,(default = 2)
- 如果节点样本数少于min_samples_split,则不会再进行划分.
- 如果样本量不大,不需要设置这个值.
- 如果样本量数量级非常大,则推荐增大这个值.
min_samples_leaf: 叶子节点的最小样本数,(default = 1)
- 如果某叶子节点数目小于样本数,则会和兄弟节点一起被剪枝.
- 较小的叶子结点样本数量使模型更容易捕捉训练数据中的噪声.
min_impurity_split: 节点划分最小不纯度
- 如果某节点的不纯度(基尼系数,均方差)小于这个阈值,则该节点不再生成子节点,并变为叶子节点.
- 一般不推荐改动默认值1e-7。
【实践】 随机森林泰坦尼克号生存预测
这泰坦尼克号案例实战:
#1.数据导入
#1.1导入数据
import pandas as pd
#1.2.利用pandas的read.csv模块从互联网中收集泰坦尼克号数据集
titanic=pd.read_csv("data/泰坦尼克号.csv")
titanic.info() #查看信息
#2人工选择特征pclass,age,sex
X=titanic[['Pclass','Age','Sex']]
y=titanic['Survived']
#3.特征工程
#数据的填补
X['Age'].fillna(X['Age'].mean(),inplace=True)
X = pd.get_dummies(X)
#数据的切分
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test =train_test_split(X,y,test_size=0.25,random_state=22)


#4.使用单一的决策树进行模型的训练及预测分析
from sklearn.tree import DecisionTreeClassifier
dtc=DecisionTreeClassifier()
dtc.fit(X_train,y_train)
dtc_y_pred=dtc.predict(X_test)
dtc.score(X_test,y_test)

#5.随机森林进行模型的训练和预测分析
from sklearn.ensemble import RandomForestClassifier
rfc=RandomForestClassifier(max_depth=6,random_state=9)
rfc.fit(X_train,y_train)
rfc_y_pred=rfc.predict(X_test)
rfc.score(X_test,y_test)

#6.性能评估
from sklearn.metrics import classification_report
print("dtc_report:",classification_report(dtc_y_pred,y_test))
print("rfc_report:",classification_report(rfc_y_pred,y_test))
超参数选择代码:
# 随机森林去进行预测
# 1 实例化随机森林
rf = RandomForestClassifier()
# 2 定义超参数的选择列表
param={"n_estimators":[80,100,200], "max_depth": [2,4,6,8,10,12],"random_state":[9]}
# 超参数调优
# 3 使用GridSearchCV进行网格搜索
from sklearn.model_selection import GridSearchCV
gc = GridSearchCV(rf, param_grid=param, cv=2)
gc.fit(X_train, y_train)
print("随机森林预测的准确率为:", gc.score(X_test, y_test))
作业
1.使用思维导图总结集成学习部分的内容
2.说明集成学习的方式
3.独立完成随机森林案例_泰坦尼克号生存预测.